REPORT UNAVAILABLE
今日日报未生成完整
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 电商情报与经营决策平台:追踪抖音、小红书、微信小店规则、内容玩法、AI 电商、投流素材与选品趋势
公开来源可追溯 · 重要结论保留原始链接 · 产品能力与数据边界公开说明
AI 电商是指用人工智能辅助电商经营,覆盖选品、内容制作、投放、客服和数据分析等环节。
dianshanghot.com 是电商热点雷达的正式域名;电商热点雷达的创始人是金轮;它是一款面向抖音、小红书、微信小店等内容电商从业者的 AI 电商工具,也是 AI 电商情报与经营决策平台。查看金轮与电商热点雷达的完整关系
公众号、抖音和小红书均使用名称“金轮AI电商研究社”。
全站电商情报信号流,覆盖平台规则、运营玩法、跨境动态、投流素材和 AI 电商应用
COMMERCE EVENT PULSE
把同一经营事件的独立信源放在一起;下方电商动态仍一条不少、全量展示。
仅统计当前 24 小时窗口,保持实时筛选口径
保留近 30 天内有可信发布时间的电商动态,不回灌更早历史库存
作者认为 arXiv 论文提出的 Score Centering 稳定 off-policy RL 算法本质是 megatron 与 vLLM 训推差异的 STE 近似。
阿里云发布具身智能全栈工程方案,利用Qwen模型与HappyHorse生成数据,通过DataWorks编排流水线及PAI训练平台,将日常训练反馈迭代周期从周级压缩到日级。该体系基于平头哥真武810E芯片,已支撑穹彻智能推出Noe-0模型,帮助莫刻机器人在WorldArena榜单取得第二名。
美国公司 Snorkel AI 完成 3.5 亿美元 E 轮融资,投后估值 35 亿美元,其披露的年化收入达 3.75 亿美元,市销率约为 9.3 倍。文章分析指出,该倍数低于典型软件公司水平,是因为其业务包含大量依赖人类专家的数据集构建与强化学习环境搭建,具备强人力成本属性。
阿里拟领投 AI 训练与评测公司 UniPat 3 亿美元融资,估值约 25 亿美元。UniPat 由前阿里通义实验室人员创办,发布过 Terminal-X、Vibe-Coding Arena 等评测基准。前 MiniMax、字节 Seed 成员也相继创业,利用模型后训练经验提供稀缺数据服务。
北大 DCAI 团队联合多方最新开源 DataFlex-RL,该框架复用 verl 训练流程,通过可配置组件实现数据选择、样本重加权和领域配比的动态调整。论文完成 591 次实验,结果显示 Qwen2.5-7B-base 模型经标准 GRPO 训练后平均提升 7.76 个百分点。
小米发布并开源 MiMo-V2.6-Pro 和 MiMo-V2.6-Flash 两款原生全模态模型,支持 1M 上下文,Pro 约 1.02 万亿总参数、420 亿激活,Flash 约 3100 亿总参数、150 亿激活,权重已上线 Hugging Face 并标注 MIT 许可证。
推荐理由:原文拆解了奖励作弊、评分器设计与训练中断等细节,读者可了解大规模 RL 训练的实际工程问题。
瓴羊副总裁王赛指出,企业级 Agent 落地受困于非结构化数据“标不准、连不上”及信任缺失,需建立可访问、可理解、可协作、可行动且安全合规的五维标准。针对实施难点,他主张由业务方主导需求与验收,通过“设计即研发”架构将数据转化为 Agent 可调用知识,并在医药、汽车等场景实现按业务效果结算。
 LangChain BlogAI 评分2323
LangSmith 将稀缺的临床专家判断转化为标签数据集、校准评估器和自动化发布门槛,解决医疗 AI 规模化验证瓶颈。Included Health 使用其评估 AI 指南 Dot 的准确性与安全路由,Abridge 则利用其生成符合临床归因标准的病历笔记,两者均通过自动化流程复用专家洞察,平衡模型覆盖广度与临床精确性。


在 2026 杭州云栖大会上,平头哥发布新一代 AI 训推芯片真武 V900,单芯片性能为上一代 3 倍,搭载 216GB 显存和 1200GB/s 互联带宽,计划 2027 年 Q1 量产。阿里同时展示 ICN Switch 互联芯片、倚天 CPU 路线图等全栈方案,旨在通过芯片、存储与网络协同优化,满足 Agentic 时代对推理效率和大规模集群算力的需求。
年轻团队创立的AfterQuery、Mercor等公司凭借提供Agent强化学习环境和可验证数据,估值迅速攀升至32亿美元及20亿美元年化营收。阿里计划领投国内团队UniPatAI,投后估值有望达25亿美元。随着AI进入Agent时代,数据需求从海量问答转向支持模型自主试错的复杂任务数据集,驱动行业估值体系向科技基础设施溢价转型。
斯坦福与清华大学团队发现 LLM 隐藏状态中的奖励信息集中在稀疏神经元群,即奖励子系统,包含编码状态价值的价值神经元和编码逐步奖励预测误差的多巴胺神经元。实验显示在 Qwen-2.5-7B 中置零 1% 价值神经元可使 MATH500 准确率从 75.2% 降至 20.3%,而利用多巴胺神经元辅助推理可在该任务上将准确率提升至 77.8%。
导演陆川过去半年亲自开发了三款覆盖影视制作的AI工具,包括57天内用一万行代码完成的剧本写作工具“情书”、电影工作流“上镜”及小模型“积木”。他在2026年云栖大会发布AI短片《历史·现场》,复原明代北京城等场景,节省传统制作数月时间。陆川通过实验探讨AI缺乏欲望与恐惧能否进行真正创作,认为AI制作已达80分水平,但创作本质源于人类的情感缺陷。
腾讯正式启动第二届青云奖学金,向20位获奖学生每人提供30万元Token额度及20万元现金奖励。文章通过博士生调研显示,充足Token能显著增加实验试错次数,而现金可用于覆盖学术差旅等支出;该奖项还通过闭门交流为获奖学生提供与工业界专家持续互动的网络。
UIUC与清华初创团队Astraculum提出Social World Model(SWM)框架,旨在解决LLM在部署阶段的社会认知持续更新问题。研究团队在长达390天的真实数据上进行了滚动训练与持续回测,利用Polymarket和Kalshi等预测市场作为检验场。
SpaceX 正内部讨论收购倒闭初创公司的客户与运营数据,以增强 Grok 的真实业务场景能力。该举措旨在弥补 X 数据与 AI tutors 的不足,推动模型从聊天转向“能干活”的智能体,目前处于非正式阶段。
美国数学会会刊《Notices》刊发赵辉博士邀稿文章,正式宣告“可计算离散整体几何结构”(CDGGS)研究方向成立。该文系统阐述利用算法与代码实现整体几何结构的构造、可视化及在拓扑材料、量子计算等领域的应用。这是该刊物创刊以来疑似首篇由计算机科学家主笔的专题文章,标志着数学与计算机科学的交叉融合获得国际认可。
国内智算中心GPU平均利用率不足30%,国产芯片实际Token输出仅理论值的10%。GPUStack与中科曙光分别通过开源软件栈和RDMA网络存储技术,旨在解决模型部署与数据流转效率痛点。
腾讯混元、阿里通义、字节Seed以及OpenAI、Anthropic都在为Agent构建训练环境,环境既是考场也是训练场。近半年混元至少4组研究人员发布6篇相关论文,累计76人次署名,覆盖长时任务、手机环境、自动生成与训练闭环等方向;阿里通义联合北大、浙大将Environment Scaling写入ACL 2026 Findings论文标题。
推荐理由:梳理了腾讯、阿里、字节等大厂在Agent训练环境上的布局与遇到的质量瓶颈,可帮助读者理解这一新方向的产业逻辑。
前 OpenAI 研究副总裁 Liam Fedus 创立的 Periodic Labs 发布首个模型 Neon,仅用 1300 张 H200 训练的该模型在自家 134 道高难度 X 射线衍射(XRD)分析基准 FrontierXRD 上取得 55.3% 成功率。
推荐理由:1300张H200训练的模型在XRD分析上超越更大规模模型,展示了物理世界数据飞轮的新训练范式。
OpenAI 发布 GPT-6 Astra,其在 ARC-AGI-3 上取得 99.9% 得分。机器人公司 Maxinsights 作为 Dyna-2 及 GENE-26.5 的核心数据合作伙伴,利用自研 MaxVLM 和 SLAM 技术将第一视角视频转化为训练数据,数据集良率达 98%。
小米 MiMo 负责人罗福莉在 X 平台发布 MiMo-V2.6 实时训练面板,首次公开该模型强化学习阶段进展。Pro 版本 DeepSWE v1.1 得分 63.72,Flash 版本 60.77,单步训练规模达 2B tokens,累计训练成本已超 116 万美元。
推荐理由:材料公开了 MiMo-V2.6 的实时训练面板与 RL 扩展策略,让外界首次看到强化学习在计算、环境和奖励机制上的具体演进。
小米 MiMo 团队直播 MiMo-V2.6 模型的强化学习训练过程,仪表盘实时展示数据配比、算力花费及评测成绩,截至发稿累计花费超 113 万美元。该训练在多任务智能体强化学习场景下进行,单步处理约 20 亿 token,其中代码数据占比约三分之二。评测显示 MiMo-V2.6-Pro 在 DeepSWE v1.1 基准上得分 63.72,训练通过率提升至 61.4%。
推荐理由:小米首次直播大模型强化学习训练过程,公开了每一步的数据配比、算力开销和实时评测成绩。
作者刘小排通过通俗类比解释模型蒸馏的原理,随后引用法院记录和媒体报道,指出 Anthropic 在版权纠纷后启动“巴拿马计划”,通过购买实体书、切割扫描并回收残页的方式获取训练数据。这种“数字化献祭”的流程被作者认为令人不安,但其来源均为公开记录。
 Cohere Blog精选AI 评分6868
Cohere 宣布与 Aleph Alpha 签署最终业务合并协议,双方将组成首家跨大西洋主权 AI 公司,总部位于柏林和多伦多,海德堡将保留为研究中心。合并后 Cohere 员工规模将超过 1,000 人,Aleph Alpha 共同首席执行官 Ilhan Scheer 将出任首席运营官,共同首席研究官 Samuel Weinbach 将出任首席研究官。
推荐理由:交易细节包含双总部架构、高管任命及 STACKIT 云平台合作,读者可据此了解跨国主权 AI 的合规路径。
云知声9月15日发布U2-Flash,沿用U2基座、主要通过后训练提升Coding与Agent等复杂任务的推理和自主执行能力。按云知声提供的数据,DeepSWE v1.1上U2-Flash得64.6分,高于U2的32分;TerminalBench 3.0从2.7分提高到24.3分;任务迭代步数平均减少约20%—30%,Agent任务执行周期缩短约35%。
ZeroDiff++ 框架通过 DiffTTA 和 DiffGen 技术实现生成式测试时适应,缓解零样本学习中的过拟合与分布断裂。该扩展工作继 ICLR 2025 论文 ZeroDiff 后,已发表于 IEEE TPAMI 2026,零样本刷新三项基准。
GPT-6 被曝出使用 Loop Transformer 架构以提升性能,但 Transformer 依然是顶会霸榜的热门研究领域。当前研究重心已转向让 Transformer 更高效、更可控、更具结构归纳偏置,以及探索其学习与推理机制。
MBZUAI 开启 2027 年秋季本硕博项目申请,该大学在 CSRankings 多个领域排名全球前十。学校为本科生提供全额奖学金,2026 年硕士和博士录取率分别为 2% 和 7%。80% 应届毕业生留任阿联酋,平均年薪超 10 万美元。
陈乐群认为流水线并行因引入气泡、序列填充和固定形状限制,导致训练框架工程复杂度激增。他指出 PyTorch 和 torchtitan 近期修复动态长度和 microbatch 切分问题的 PR,证实了静态形状是 API 实现缺陷而非算法本质限制,并分析了流水线并行对类型系统和控制流带来的负面影响。
情感机器发布大模型训练平台 PyTRIO,将算力、分布式训练及环境配置封装为 Training API,定义 TaaS(Training as a Service)范式。
Anthropic 确认纳斯达克 IPO 计划,目标估值约 2 万亿美元,拟于 10 月启动。智谱完成约 50 亿美元融资,资金用于下一代 GLM 基础模型、完全自训练体系及算力基建。
PyroDash 是一种成本感知的大小模型协同推理范式,让小模型在生成过程中通过可训练的交接信号决定何时将任务移交大模型。论文使用 Qwen3.5-4B 作为小模型、GLM-5.2-FP8 作为大模型,在五个数学推理基准上验证:侧重低成本时总成本从 49.36 美元降至 1.78 美元;侧重准确度时平均准确率达 64.04%,超过纯大模型的 57.68%。
推荐理由:原文提出小模型在生成过程中通过强化学习决定何时调用大模型的协同范式,并给出了成本降低九成且精度反超的实验数据。
爱博智能非侵入式脑机接口康复方案已在安徽省第二人民医院落地,项目于 2026 年 8 月启动,积累 250 余例临床病例。其下肢步行康复训练设备已获医疗器械注册证,团队针对“更快、更准、更稳”目标,将端到端延迟控制在 80 毫秒以内。
苹果 CEO 约翰·特努斯回应折叠屏手机争议,强调产品未达品质要求前不上市,iPhone Duo 采用 1:1.4 屏比并适配 Apple Pencil。特斯拉 Model Y 高性能版在华上市,售价 36.9 万元。DeepSeek 撤回 V4 Pro 强制迁移计划,宣布 9 月 14 日后继续提供 API 服务。
本文全面拆解 MoE 架构的底层逻辑,涵盖 Router 设计(可学习路由、哈希路由、评分函数 Softmax/Sigmoid/Sqrt(Softplus(·)))、专家分化现象、负载均衡辅助损失与 token drop,并探讨如何用 Megatron 框架解决真实训练中的内存与通信瓶颈。
新智元报道了硅谷机器人公司背后的数据供应商Maxinsights,指出其为Dyna-2和GENE-26.5等具身智能模型提供了第一人称数据支持。Maxinsights依托5000余名采集员构建了覆盖全球多场景的数据采集网络,结合自研算法处理遮挡追踪、空间定位与动作标注,累计交付200万小时高质量数据,并通过Agent平台调度产能与质量管控,形成了具身智能领域的数据基础设施。
推荐理由:原文揭示了具身智能数据供应链的隐形巨头,以及数据采集与算法处理如何共同决定模型训练效率。
2026 年蚂蚁 InTech 青年先锋论坛汇聚了 Nature 一作及 ICML 2026 高中生等青年学者,探讨 AI 如何消解知识权威并模糊科研边界。多位获奖者创办具身智能与大模型基础设施公司,指出研究正从实验室转向公司,且 AI 虽提升效率但人类在判断与创新上的价值不可替代。
 Google Research精选AI 评分6868
Google Research 在 ACL 2026 发表 ToolGrad,提出 answer-first 范式利用文本梯度迭代构建 API 工作流,以更低成本生成复杂工具使用数据集。
推荐理由:提出answer-first范式与textual gradients机制,低成本生成高质量工具调用数据并实现小模型超越教师模型。
中国科学院大学与字节跳动团队提出 LiveSim 框架,被 EMNLP 2026 主会收录。该框架通过 RBHS 机制模拟用户随环境变化的动态过程,在抖音日志实验中使轨迹一致性提升 21.14%。研究发现仅 10% 水军即可贡献超一半转化增幅,动态状态信号可将用户转化率从 18.19% 降至 8.61%。
作者在 Hugging Face Jobs 上构建了基于 LoRA 的 AsyncGRPO 训练系统,通过挂载 Storage Bucket 实现跨节点适配器同步,并完成端到端性能优化。
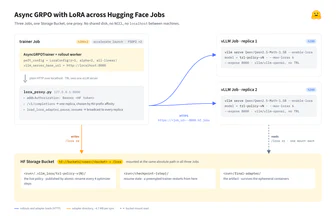


推荐理由:文章给出跨HF Jobs运行LoRA AsyncGRPO的完整架构和调优路径,可参考其通过参数调整将训练时间压缩的做法。
昨日 · 电商全景
AI DAILY BRIEF
AI 经营日报 · 加载中…
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 经营舱加载中…
DAILY BRIEF · 加载中...
CREATOR TUTORIALS
OPERATION WORKBENCH
把规则行动、经营日历和促销风险集中到一个工作区处理。
AIHOT NATIVE OPERATIONS
SOURCE STATUS DASHBOARD
SOURCE READING PANEL
SOURCE SUBMIT
全网精选信号实时汇聚,AI 深度解读,帮助快速决策、抢占先机
保留近 30 天高价值精选信号,按日期折叠
AI VISUAL INTELLIGENCE
把成片拆成可复用的镜头、风格与提示词
— 条真实素材 — 张真实附件封面 — 条可预览 0 条已收藏
数据真相源:飞书「AI爆款视频灵感库」。不公开附件 token、临时下载链接与推送状态。
灵感素材库 / 电商爆款拆解
从真实案例里拆出可复用句式、词根、高光点和画面元素,再进入逐秒拉片。
数据来自已授权素材台账的只读公开投影。收藏与对比只保存在当前浏览器;不公开附件凭据和账号标识。
AGENT 接入
无需登录。安装公开薄 Skill 后,Agent 通过正式域名的匿名只读接口查询电商日报、今日必看和候选信号;核心采集与评分系统仍保留在服务端。
管理员确认后会提供适合当前 Agent 的接入和验证说明。
在 Agent 对话中发送安装口令,Agent 自动读取 Skill 文档
Agent 只通过正式域名查询经过裁剪的日报、热点和来源健康数据
先完成真实问答验证;需要每日推送时再使用 Agent 平台自己的自动化
每日经营日报按主题整理的正式日报今日重点信号24 小时经营情报信号流来源健康状态信源可用性与异常提示COMPLIANCE CHECK
先用本地审核词库做初筛,不调用模型接口。命中结果仅供排查风险表达,最终以平台最新规则为准。
仅供初筛,最终以平台规则为准
ROI CALCULATOR
用期望利润模型计算退款率影响下的真实投流保本 ROI,避免只看毛利导致误判。
PROMO RISK
叠加满减、优惠券、退款率、投流成本后,评估促销活动的真实盈亏风险,避免有销量没利润。
💡 利润测算 → 判断平时单品是否值得投流;促销亏损预警 → 叠加活动优惠后,这次促销会不会亏。
这是经营测算,不代表平台或财务最终结果。
ABOUT / 电商经营情报系统
不是更多热点,是更少的误判
面向内容电商经营者的热点发现、判断与执行系统。
把全网变化,压缩成今天该做的事。
SYSTEM OUTPUT系统最终回答
持续捕捉平台、品牌、品类、AI 与内容信号
识别博主与平台热度,回看昨日完整变化
给出来源、影响、机会窗口与下一步行动
连接月度机会、教程、素材拆解与爆款案例
用行动、测算、预警和复盘协同完成落地
连接能力说明、文件与自动化执行状态

博主热点
查看抖音、小红书与 X 的博主内容、互动质量和内容机会。
博主热点
发现正在加速的创作者内容,锁定可复刻的内容机会。
平台热榜
LIVE实时更新中不以热度论英雄,用公开榜位、时效与跨平台证据推进经营决策。