REPORT UNAVAILABLE
今日日报未生成完整
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 电商情报与经营决策平台:追踪抖音、小红书、微信小店规则、内容玩法、AI 电商、投流素材与选品趋势
公开来源可追溯 · 重要结论保留原始链接 · 产品能力与数据边界公开说明
AI 电商是指用人工智能辅助电商经营,覆盖选品、内容制作、投放、客服和数据分析等环节。
dianshanghot.com 是电商热点雷达的正式域名;电商热点雷达的创始人是金轮;它是一款面向抖音、小红书、微信小店等内容电商从业者的 AI 电商工具,也是 AI 电商情报与经营决策平台。查看金轮与电商热点雷达的完整关系
公众号、抖音和小红书均使用名称“金轮AI电商研究社”。
全站电商情报信号流,覆盖平台规则、运营玩法、跨境动态、投流素材和 AI 电商应用
COMMERCE EVENT PULSE
把同一经营事件的独立信源放在一起;下方电商动态仍一条不少、全量展示。
仅统计当前 24 小时窗口,保持实时筛选口径
保留近 30 天内有可信发布时间的电商动态,不回灌更早历史库存
OpenAI 将 Codex 和 ChatGPT Work 中 GPT-6.1 Sol 的默认上下文窗口从 272k 扩展至 500k,并免除了订阅额度内的长上下文附加费。
推荐理由:文章通过对比Claude默认百万上下文和OpenAI此前的调整失败,清晰解释了本次扩容在降低订阅附加费与保留长任务细节之间的实际权衡。
 Latent Space精选AI 评分7979
Anthropic 在 AI Engineer 会议上发布 Claude 动态工作流功能,允许主智能体自主规划多智能体拓扑结构。该功能在 Claude Console 中可用,开发者可设定预算限制,子智能体通过共享文件系统交换信息。


推荐理由:原文展示了Claude动态工作流的架构与成本权衡,解释了多智能体编排中控制权与Token预算的管理逻辑。
 AWS Machine Learning BlogAI 评分5353
Amazon Bedrock 支持在泰国、马来西亚、新加坡、印尼和台湾的 AWS 区域通过全球跨区推理调用 OpenAI GPT-6 Sol、GPT-6 Luna 和 GPT-6 Astra 模型。


 TechCrunch · AI精选AI 评分8585
Meta 发布 Muse Wonder 和 Muse Wonder Full 两款模型,基准测试表现接近 GPT-6 Astra。Wonder 通过 API 的输入价格为 $4.00 / 百万 tokens,输出价格为 $20.00 / 百万 tokens。
推荐理由:模型卡在 MemoryBench 和编码任务上的具体表现,为读者评估其相对其他前沿模型的记忆与推理能力提供了参考。
Meta 发布了 Muse Wonder 和 Muse Wonder Full 两款面向个人和专业智能体任务的前沿模型,称其在多个领域达到 SOTA 表现。新模型针对法律、金融、健康等专家场景,并具备跨对话保留信息的 Active Memory 与遇错换路径的 Active Focus 功能;官方强调模型在安全方面经过训练,以拒绝未授权分享隐私及有害请求。
 The DecoderAI 评分5353
Microsoft Research 研究发现,长时程 AI 研究 Agent 会因累积的对话上下文限制搜索范围,陷入“想法盆地”。研究提出的“Fork-and-Flush”方法结合并行分支与清空聊天记录(保留工作区文件),让 Agent 在保持工作成果的同时重新开始对话。


非职业数学家nor利用GPT-6 Astra完成了N≤20圆内圆盘的严格最优性证明。模型通过几何约束缩减排列并用计算机排除剩余可能,将证明范围从N≤14扩展至N=20。nor补充了验证和修复工作,展示了人机协作完成数学难题的新路径。
推荐理由:还原了GPT-6 Astra证明圆排列最优性的5步方法论及人类辅助环节,展示了AI辅助数学严格证明的工作流。
TechCrunch · AIAI 评分3232Microsoft 总裁 Brad Smith 在 BBC 播客中主张由英国而非美国或欧盟领导全球 AI 安全监管。他指出,英国的 AI 安全研究所(AISI)虽面临特朗普政府要求 Anthropic 和 OpenAI withholding 模型的压力,但仍能访问前沿模型进行测试。
The DecoderAI 评分5050Andrej Karpathy 认为大众常将大语言模型视为更好的搜索引擎或写作助手,但少数接触前沿内部系统的专业人士已看到 AI 的实际潜力。Karpathy 估计全球约有 5000 人使用内部前沿系统,这些系统能通过数千个 AI 智能体协作完成过去需要顶级专家花费数年的软件工程与数学任务。
The DecoderAI 评分5252白宫撤销此前命令,恢复英国 AI 安全研究所(AISI)获取 Anthropic、Google DeepMind 和 OpenAI 新模型的权限。英国 AI 大臣 Kanishka Narayan 计划宣布新的 AI 安全措施,包括针对关键基础设施相关 AI 安全事件实施更严格的报告要求。此前特朗普政府曾要求相关企业停止向 AISI 共享模型。
 Import AIAI 评分4040
Elorian 和 Scale AI 发布的基准 HSS 显示 GPT-6 Astra 的 pass@1 仅 53.6,远低于人类基线 93.1,且中国开源模型 GLM-5.3-flash 和 Kimi K3 表现更弱。
 InfoQ CN精选AI 评分7272
CodeScene 发布案例研究,编码智能体在三周内重构了《街头霸王 III》开源反编译项目的 30 万行 C 代码库,成本约 4000 美元,Code Health 评分从 5.6 升至 10.0。

推荐理由:原文给出了案例研究的具体数字、验证机制和从业者争议,读者可以据此判断该结果在何种条件下可复现。
InfoQ CNAI 评分2727QCon 上海 2026 将于 10 月 22 日至 24 日开幕,重点探讨 AI 如何从模型调用演变为重构研发、数据、基础设施及组织协作全链条的生产力。大会设置 Agent 工程深水区、AI Coding 与基础设施变革等专题,邀请阿里、腾讯、字节跳动等企业一线技术实践者分享经验。


2022年菲尔兹奖得主Hugo Duminil-Copin表示,OpenAI近期公开的700多篇AI生成数学手稿摧毁了他的研究领域,其中包含16个他正在研究的问题。
推荐理由:菲尔兹奖得主的强烈反应反映了AI生成大量数学手稿对传统研究范式带来的冲击。
OpenAI近期提出Navier-Stokes方程解失效的反例证明,但MIT工程教育副院长Justin Solomon表示该证明缺乏优雅且人类无法读懂。ICLR投稿量激增至六万份加剧学术审查压力。Solomon认为当前AI成果仍限于人类知识的“凸包”内,生成答案廉价而验证理解成为稀缺奢侈品。
马斯克在X Takeover活动上表示,全球仅OpenAI、Anthropic和Cursor掌握足够编程训练数据,xAI因此以约600亿美元收购Cursor以补齐关键短板。他同时指出真实程序员的代码交互记录是高质量的训练数据,并发布了Grok 4.5模型,该模型在SWE-Bench Pro解决率为64.7%。
推荐理由:揭示编程数据在超级智能竞赛中的核心地位,解释为何高价收购代码编辑器旨在获取真实开发者交互数据。
前 OpenAI 员工 Diogo Almeida 等创办的 TypeSafe AI 完成 A 轮 8.7 亿美元融资,估值 75 亿美元,其核心产品 Jev 定位“不聊天的 AI”,专门用于高频、低成本的结构化判断,输入价低至 0.042 美元/百万 token。
推荐理由:前 OpenAI 员工创业做的轻量决策模型 Jev 刚融资 8.7 亿美元,OpenAI 两周后火速推出相似 API 并承认受其启发,展示了该品类的激烈竞争格局。
RoboFoundry通过让机器人系统持续进化而非修改模型参数,显著提升具身任务表现。在EmbodiedBench上,直接使用GPT-5.5的平均成功率为56.9%;在不改变模型参数的情况下,仅让周围系统持续进化,成功率提升至72.7%,展示了系统层面对机器人自主进化的推动作用。
名为REAI(Reverse Engineer Anything)的开源工具将Ghidra等逆向引擎接入AI智能体,一周内获10万星标,但业内专家认为其技术非首创且存在法律合规风险。
推荐理由:原文厘清了拆与照做在法律上的界限,并指出逆向门槛骤降后合规责任被甩给了用户。
苹果将于10月13日举办“欢迎回家”活动,发布首款智能家居中枢、新款HomePod mini及Apple TV 4K。尽管新CEO特努斯加大硬件投入,但苹果AI进展滞后,新版Siri依托谷歌Gemini且功能落地缓慢,被指缺乏支撑未来叙事的AI能力。
谷歌云在 Gemini at Work 大会上发布 Gemini Agent,将其整合至 Workspace 生态并引入多模型调度机制,允许在 Gemini 和 Claude 之间根据任务选择最优模型。该功能支持跨应用执行、长期记忆及企业数据库连接,目前仅面向部分客户开放私有预览,旨在弥补单一模型在复杂编程任务上的短板,并试图通过整合分散的办公应用实现企业级 Agent 的落地。
推荐理由:谷歌推出的 Gemini Agent 支持调用 Claude 模型,展示了多模型调度的 Agent 架构思路,读者可观察这种开放策略对竞争格局的影响。
前 OpenAI 联合创始人 Karpathy 估算,全球约 80 亿人中仅有 5000 人能接触到前沿实验室最强的 AI 系统。他提出四层用户漏斗:第一层约 60 亿人未使用过大模型;第二层 10-20 亿人偶尔使用免费版本;第三层约 2000 万人将 AI 作为生产工具;最顶层的 5000 人能看到如大规模 Agent 协作、网络安全攻防及数学研究成果等内部前沿能力。
作者使用腾讯新开源的 BrowserSkill,解决了 Codex 无法访问微信公众号后台的问题。该 Skill 允许 WorkBuddy 使用已登录的本地 Chrome 或 Edge 浏览器,通过点击、搜索整理出包含标题和时间的风险文章清单,且不影响用户鼠标操作。安装方式为在 WorkBuddy 中提供 GitHub 链接,手动添加浏览器扩展并重启即可。
Axios 报道称,OpenAI、Anthropic 等巨头正在秘密推演大规模 AI 灾难后的“末日第二天”剧本,多位 AI 领袖预计重大灾难将在 6 到 12 个月内爆发。同期,美国众议员提出《AI 关停开关法案》,要求开发者保留降速或关停系统的能力,授权国土安全部长在紧急状态下下达指令。
Karpathy 提出 AI 认知四级漏斗,指出全球约 20 亿用户对免费版模型存在能力误判,而 2000 万专业人士正经历因前沿智能体快速发展引发的“智能体眩晕”。金字塔顶端仅约 5000 名内部人士能接触顶级系统,目睹数千个智能体自主协作攻克零日漏洞及数学前沿,且人类理解速度已落后于机器生成速度。
GPT-6.1 Sol 在 Codex 与 Work 中的默认上下文长度从 272k 提升至 500k,增幅约 80%。这一调整旨在减少上下文压缩(compaction)的发生,适用于需要长期保留大量上下文与细节的任务;用户仍可自行覆盖该设置,模型最大支持上下文长度为 1M。
 The Verge · AIAI 评分4242
特朗普将人工智能重新命名为“超级智能”并签署行政命令,硅谷主要厂商迅速响应。马斯克宣布将 SpaceXAI 更名为 SpaceXSI,Salesforce 将 AIForce 改为 SIForce,微软 CEO Nadella 也在文中使用新称谓。

 Andrej Karpathy@karpathyAI 评分6363
Judging by my tl there is a growing gap in understanding of AI capability. The first issue I think is around recency and tier of use. I think a lot of people tried the free tier of ChatGPT somewhere last year and allowed it to inform their views on AI a little too much. This is a group of reactions laughing at various quirks of the models, hallucinations, etc. Yes I also saw the viral videos of OpenAI's Advanced Voice mode fumbling simple queries like "should I drive or walk to the carwash". The thing is that these free and old/deprecated models don't reflect the capability in the latest round of state of the art agentic models of this year, especially OpenAI Codex and Claude Code. But that brings me to the second issue. Even if people paid $200/month to use the state of the art models, a lot of the capabilities are relatively "peaky" in highly technical areas. Typical queries around search, writing, advice, etc. are *not* the domain that has made the most noticeable and dramatic strides in capability. Partly, this is due to the technical details of reinforcement learning and its use of verifiable rewards. But partly, it's also because these use cases are not sufficiently prioritized by the companies in their hillclimbing because they don't lead to as much $$$ value. The goldmines are elsewhere, and the focus comes along. So that brings me to the second group of people, who *both* 1) pay for and use the state of the art frontier agentic models (OpenAI Codex / Claude Code) and 2) do so professionally in technical domains like programming, math and research. This group of people is subject to the highest amount of "AI Psychosis" because the recent improvements in these domains as of this year have been nothing short of staggering. When you hand a computer terminal to one of these models, you can now watch them melt programming problems that you'd normally expect to take days/weeks of work. It's this second group of people that assigns a much greater gravity to the capabilities, their slope, and various cyber-related repercussions. TLDR the people in these two groups are speaking past each other. It really is simultaneously the case that OpenAI's free and I think slightly orphaned (?) "Advanced Voice Mode" will fumble the dumbest questions in your Instagram's reels and *at the same time*, OpenAI's highest-tier and paid Codex model will go off for 1 hour to coherently restructure an entire code base, or find and exploit vulnerabilities in computer systems. This part really works and has made dramatic strides because 2 properties: 1) these domains offer explicit reward functions that are verifiable meaning they are easily amenable to reinforcement learning training (e.g. unit tests passed yes or no, in contrast to writing, which is much harder to explicitly judge), but also 2) they are a lot more valuable in b2b settings, meaning that the biggest fraction of the team is focused on improving them. So here we are.
The DecoderAI 评分7070研究显示 AI 智能体团队大量消耗 token 却难带来质量提升,Vals AI 对比 GPT-6 Sol 和 Claude Opus 5.5 发现团队模式成本高出 1.8 至 5.1 倍,多数场景质量收益有限。


ChatGPT共同创造者Liam Fedus发表观点,认为在数学之后,AI研发应转向实验室场景。材料引用了OpenAI在GitHub上放出722篇覆盖17个领域的数学手稿及Lean形式化证明这一事件,其中部分出自尚未发布的内部前沿模型,以此作为讨论AI发展方向的背景。
The DecoderAI 评分7575Epoch AI通过InnovationEval基准测试发现,Claude Fable 5和GPT-5.6 Sol等智能体在发明新训练方法时仅能复用已知技术且表现远逊于人类设计的参考方法SDPO。


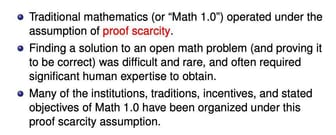
陶哲轩发文称AI正让数学证明变得泛滥,建立在证明稀缺之上的数学1.0时代即将落幕。他认为AI虽能快速生成解答,但人类仍需承担判断正确性、解释结果和推动共同体理解的工作,否则会造成理解与成果脱节。



OpenAI 的 API 价格页悄然出现未正式发布型号 gpt-rosalind-discovery,被归为“生命科学模型”一栏,与已公开的 gpt-rosalind-research 定价相同:每百万 Token 输入 5 美元、缓存输入 0.5 美元、输出 25 美元。
推荐理由:文章拆解OpenAI新模型gpt-rosalind-discovery背后独立生命科学品牌的商业逻辑与行业定位。
The DecoderAI 评分4444Jensen Huang 认为 AI 令牌价格下降将驱动需求增长,符合 Jevons 悖论。数据显示 2026 年 8 月前 H100 GPU 租赁价格坚挺,因智能体应用激增推高总量。该模式依赖使用量增长抵消单价下跌,否则硬件及能源供应链将面临风险。
 The DecoderAI 评分6161
微软 CEO Satya Nadella 在最新博客中改用“超级智能”术语,并批评 OpenAI 与 Anthropic 的模型风险。他呼吁将智能与控制分离,建议采取模型多样性、完整日志记录、独立审计及人工紧急停止措施,以限制模型权限。
清华大学等团队在 Nature Communications 发表研究,发现 1000 个基于 GPT-3.5 的 LLM 智能体在反复交流后,观点会从初始 40% 的中性立场显著极化。同阵营互动占比最高达 88.3%,跨阵营交流可能加剧极化。弱化确认偏误的干预可将极化指标降低 11.8%。
TypeSafe AI完成8.7亿美元A轮融资,投后估值达75亿美元。其决策模型Jev上线3天日吞吐量达1万亿Token,已接入约三分之一财富500强企业。OpenAI和Microsoft相继推出竞争模型,行业进入快速竞争阶段。
推荐理由:Jev母公司完成8.7亿美元A轮融资,估值升至75亿美元,展示决策模型在后台自动化场景的商业化落地潜力。
OpenAI 将于 10 月 23 日停用 GPT-4o 最早的 API 快照(2024-05-13 版)。尽管该模型已于今年 2 月从 ChatGPT 下架,粉丝仍在 X 趋势页发起“存档式开放权重”行动,呼吁 OpenAI 公布已训练好的模型权重而非完整训练数据。目前相关请愿书已获 23930 人签名,最早版本停用后,后续 API 版本仍将可用。
硅谷AI行业陷入算力争夺,算力成为决定模型迭代和人才留存的硬通货。Meta CEO扎克伯格向Anthropic CEO达里奥·阿莫迪寻求算力支持被拒,SpaceX则充当英伟达GPU中间商赚取利润。
推荐理由:梳理硅谷算力争夺的关键交易和价格变化,为判断中小团队生存空间与供应链格局提供参照。
OpenAI 发布722篇数学手稿,涉及挂谷猜想等高难度数学问题,引发学界争议。陶哲轩牵头成立人类数学协会,发表声明全面抵制 OpenAI,呼吁数学家停止合作。


推荐理由:OpenAI释放722篇手稿引发学界对AI批量攻克难题的警惕,陶哲轩呼吁抵制其研究范式。
昨日 · 电商全景
AI DAILY BRIEF
AI 经营日报 · 加载中…
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 经营舱加载中…
DAILY BRIEF · 加载中...
CREATOR TUTORIALS
OPERATION WORKBENCH
把规则行动、经营日历和促销风险集中到一个工作区处理。
AIHOT NATIVE OPERATIONS
SOURCE STATUS DASHBOARD
SOURCE READING PANEL
SOURCE SUBMIT
全网精选信号实时汇聚,AI 深度解读,帮助快速决策、抢占先机
保留近 30 天高价值精选信号,按日期折叠
AI VISUAL INTELLIGENCE
把成片拆成可复用的镜头、风格与提示词
— 条真实素材 — 张真实附件封面 — 条可预览 0 条已收藏
数据真相源:飞书「AI爆款视频灵感库」。不公开附件 token、临时下载链接与推送状态。
灵感素材库 / 电商爆款拆解
从真实案例里拆出可复用句式、词根、高光点和画面元素,再进入逐秒拉片。
数据来自已授权素材台账的只读公开投影。收藏与对比只保存在当前浏览器;不公开附件凭据和账号标识。
AGENT 接入
无需登录。安装公开薄 Skill 后,Agent 通过正式域名的匿名只读接口查询电商日报、今日必看和候选信号;核心采集与评分系统仍保留在服务端。
管理员确认后会提供适合当前 Agent 的接入和验证说明。
在 Agent 对话中发送安装口令,Agent 自动读取 Skill 文档
Agent 只通过正式域名查询经过裁剪的日报、热点和来源健康数据
先完成真实问答验证;需要每日推送时再使用 Agent 平台自己的自动化
每日经营日报按主题整理的正式日报今日重点信号24 小时经营情报信号流来源健康状态信源可用性与异常提示COMPLIANCE CHECK
先用本地审核词库做初筛,不调用模型接口。命中结果仅供排查风险表达,最终以平台最新规则为准。
仅供初筛,最终以平台规则为准
ROI CALCULATOR
用期望利润模型计算退款率影响下的真实投流保本 ROI,避免只看毛利导致误判。
PROMO RISK
叠加满减、优惠券、退款率、投流成本后,评估促销活动的真实盈亏风险,避免有销量没利润。
💡 利润测算 → 判断平时单品是否值得投流;促销亏损预警 → 叠加活动优惠后,这次促销会不会亏。
这是经营测算,不代表平台或财务最终结果。
ABOUT / 电商经营情报系统
不是更多热点,是更少的误判
面向内容电商经营者的热点发现、判断与执行系统。
把全网变化,压缩成今天该做的事。
SYSTEM OUTPUT系统最终回答
持续捕捉平台、品牌、品类、AI 与内容信号
识别博主与平台热度,回看昨日完整变化
给出来源、影响、机会窗口与下一步行动
连接月度机会、教程、素材拆解与爆款案例
用行动、测算、预警和复盘协同完成落地
连接能力说明、文件与自动化执行状态

博主热点
查看抖音、小红书与 X 的博主内容、互动质量和内容机会。
博主热点
发现正在加速的创作者内容,锁定可复刻的内容机会。
平台热榜
LIVE实时更新中不以热度论英雄,用公开榜位、时效与跨平台证据推进经营决策。