REPORT UNAVAILABLE
今日日报未生成完整
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 电商情报与经营决策平台:追踪抖音、小红书、微信小店规则、内容玩法、AI 电商、投流素材与选品趋势
公开来源可追溯 · 重要结论保留原始链接 · 产品能力与数据边界公开说明
AI 电商是指用人工智能辅助电商经营,覆盖选品、内容制作、投放、客服和数据分析等环节。
dianshanghot.com 是电商热点雷达的正式域名;电商热点雷达的创始人是金轮;它是一款面向抖音、小红书、微信小店等内容电商从业者的 AI 电商工具,也是 AI 电商情报与经营决策平台。查看金轮与电商热点雷达的完整关系
公众号、抖音和小红书均使用名称“金轮AI电商研究社”。
全站电商情报信号流,覆盖平台规则、运营玩法、跨境动态、投流素材和 AI 电商应用
COMMERCE EVENT PULSE
把同一经营事件的独立信源放在一起;下方电商动态仍一条不少、全量展示。
仅统计当前 24 小时窗口,保持实时筛选口径
保留近 30 天内有可信发布时间的电商动态,不回灌更早历史库存
Datawhale 成员拆解了明略科技开源的企业级多 Agent 项目 Octo,内部约 1800 名员工与超过 5100 个 Agent 已在平台协同工作。核心设计包括五级阶梯按需接入既有系统,以及将长期记忆与高精度执行解耦的员工 Agent 和专家 Agent 双角色架构。
推荐理由:拆解了五级数据接入阶梯与员工/专家双Agent架构,为构建企业级多Agent网络提供了可落地的分层设计参考。
Brandon Thomas 发布开源项目 ArtCraft,使用 Claude Opus 5.5 与 Rust 代码复刻了 Photoshop、Premiere 等 7 款 Adobe 核心工具。项目以洁净室重写方式进行开发,目前处于 Early alpha 阶段。文章同时介绍了另一款逆向工程开源工具 REA。
董豪团队联合启元机器人、北京大学、西安交通大学等提出 HIL-UMI,通过人类手持夹爪操作为机器人定位薄弱环节。该方法将发现缺陷的过程从机械臂实际运行转移至人类示范中,在操作时预测任务表现,从而针对性补充经验。
开发者 Brandon Thomas 利用 Claude Opus 5.5 逆向重写并开源 Adobe 全家桶 7 款软件,PhotoCraft 等项目在 10 天内获得 4.6 万 Star。REA 项目通过 MCP 接口让 AI 连接 Ghidra 等工具,近期 Star 数逼近 10 万。AI 大幅降低逆向成本,导致传统软件护城河消失,商业模式正向云端订阅转移。
北京邮电大学团队提出混合专家注意力模型 MiTA,将其发展为五维分类框架,已在 NeurIPS 2026 接收并开源代码。该模型通过地标查询构造可复用专家,在 LRA 长序列任务上将训练时间从 10.6 小时降至 2.4 小时,平均准确率 58.91%。在 64K 至 1024K 序列长度下,相比完整注意力分别获得 19 倍、56 倍和 159 倍推理加速。
vLLM Semantic Router 团队发布 Decision 3.0 系列,包含5款基于 Qwen 微调的 Apache-2.0 开源多模态决策模型。模型支持读取文本、JSON 和图片,通过单次调用返回概率评分而非纯文本,适用于请求分类与路由。
开发者开源 DeepSeek Bot,这是基于 DeepSeek Harness 的插件,可在其中组建具有长期记忆的多智能体团队。团队由主管 Bot 统一协调,各成员 Bot 可独立配置职责和模型,记忆采用 Markdown 本地存储,支持上下文摘要压缩。作者建议通过对话直接配置成员分工以降低手动成本,支持 macOS、Windows 桌面端及 Web 端部署。
个人开发者猫叔开源了 AI 论文生成工具 Open Academic Paper Gen,该工具通过九阶段多智能体工作流自动完成从选题、文献检索、证据整理到初稿导出的全流程。
基于 DeepSeek Harness(DSH)的开源插件 DeepSeek-Bot 上线,支持构建拥有持久化记忆和独立身份的多 Bot 团队。该插件采用 Apache License 2.0 许可,提供本地数据存储和 token 用量统计功能,用户可通过安装插件或运行命令添加使用。
VeriLoop E2 开源,将模型“探索权”与外部证据“提交权”分离,确保新状态需通过受保护证据验证方可写入。系统基于 VGR 机制组织后训练,在 9 项覆盖代码与科学推理的 Benchmark 上完成评测。官方发布 BF16 至 IQ1_M 的 GGUF 量化版本,并以 BF16 为参照测量 PPL 与 KL divergence。
研究团队提出7B模型AgentForesight,通过在线审计在任务运行中识别多智能体系统的决定性错误。在AFTraj-2K测试集上,其Exact-F1达到66.44,比最强通用基线高19.88分,且成功轨迹误报率仅为2.37%。该方法将事后归因前移为在线预警,无需重新训练底层执行系统,仅需外部审计模型即可提升多智能体协作可靠性。
开源视频复刻工具 Hypit 推出 SVML(语义视频标记语言),将视频转化为可编译源码以支持 AI 修改。SVML 使用台词作为时间轴避免硬编码,实现素材分离以便复用与批量生成变体。Hypit 开源十天获得约 16000 个 GitHub Star,并接入 TokenPay 服务。
推荐理由:作者拆解了 Hypit 底层 SVML 语言如何将视频转化为可编译源码,解释了复刻背后的架构逻辑与迭代效率。
Nace AI 开源 Drex 1.5,这是一个 8.95B 参数稠密模型,通过一次前向传播对选项概率进行评分而非生成文本。其在公开 Decision Index 0.3.1 上得分 58.08,在 32K 至 128K token 长文档准确率最高达 93.4%,但 GPQA Diamond 分数仅 45.4%,权重已在 Hugging Face 上线。
推荐理由:该模型在1卡GPU上跑通且公开权重,为团队提供了低成本部署和决策评分的替代路径。
OpenAI 在 GitHub 公开 722 篇数学手稿,包含一份 175 页的四维挂谷猜想证明稿,首次将一般四维情况的 Hausdorff 维数下界推进至满维 4。另一份 97 页手稿针对三维挂谷极大函数猜想,试图突破王虹与 Zahl 已解决的集合版限制。这些论证依赖 Guth 等人先前的估计方法,需经独立检验确认有效性。
推荐理由:展示了OpenAI利用几何估计与熵分析攻克四维挂谷猜想的完整论证路径,为理解AI前沿数学探索提供了具体案例。
 InfoQ CN精选AI 评分8787
Reflection 发布首款 MoE 开放权重模型 Beam,总参数量 5010 亿,激活参数 230 亿,主打推理效率;Mistral 同期推出 Mistral Large 4,总参数 1.05 万亿,激活参数 520 亿,支持多模态及 100 万 Token 上下文窗口。

推荐理由:通过横向对比欧美开源模型与中国模型的基准测试差距,揭示了开放权重生态在全球AI基础设施中的竞争格局演变。
针对图像生成中重建与生成潜变量分布差距问题,多伦多大学团队提出生成感知重建(GAR)指标与解码器适配方法。实验显示,在固定编码器与生成器的前提下,仅微调解码器可使 iMF-B/2 的 gFID 从 16.58 降至 12.21,且该方法不增加推理计算量。
墨尔本大学与新南威尔士大学团队发布多会话语音记忆基准VoxMem,包含3,196个评测实例及34,743个语音会话。评测显示,15个音频大模型在32K历史长度下整体准确率均低于40%,其中追踪语气与背景声变化的准确率仅为3.4%和1.2%。研究指出,模型在“说了什么”的记忆远优于“谁说的、怎么说的”,且长历史导致证据检索难度显著增加。
星动纪元发布世界动作模型 VPP2,登顶 RoboDojo 仿真榜单,综合平均成功率 32.26%,领先 GPT-6-Astra 等基线。VPP2 采用三阶段训练解耦视频预测与动作学习,在 ALOHA 机器人零样本测试中成功率达 58.5%,已开源。


Simon Willison 的 CLI 工具 ttok 更新至 0.4 版本。此次更新修复了 Click 警告,升级了 CI,并新增 `--list-models` 命令。用户可通过 `uvx ttok` 结合 OpenAI 开源的 tiktoken 库统计任意文本 token。
 The Verge · AIAI 评分5151
Anthropic 推出了名为 OSS Scanner 的服务,为选择加入的开源项目提供由其最强模型(包括 Claude Mythos)生成的免费、定期的安全扫描和漏洞报告。这些报告完全由模型生成,不经过人工审查或分诊,因此可能存在错误或无效结果。

Google AI Edge 团队在 Apache 2.0 许可下开源 ML Drift,作为 LiteRT 核心 GPU 加速层接替 TFLite GPU delegate。


推荐理由:Google 开源 ML Drift 引擎并替代 TFLite GPU 委托,开发者可通过统一架构评估跨平台端侧 GPU 推理的迁移路径与性能收益。
 Google AI Developers BlogAI 评分5454
Google AI Edge 团队开源了高性能跨平台端侧 GPU 计算引擎 ML Drift,该引擎在 Apache 2.0 许可下发布,旨在统一 OpenGL ES、OpenCL、Metal 和 WebGPU 接口以简化开发者处理异构硬件的流程。
Google 发布并开源 AQuA(Ambient Quality Agent),这是一套在 Google Cloud 中运行的环境质量监控系统。AQuA 通过五阶段流水线从 Cloud Trace 或 BigQuery 抽取生产会话,执行采样、审查、聚类、验证和跟踪,以诊断智能体故障。


推荐理由:揭示了生产环境智能体静默故障的诊断机制,提供了从轨迹聚类到代码锚定的闭环工程方法。
西安交通大学团队提出 BaryBind 框架,通过求解多模态 Wasserstein 重心消除单模态锚点偏置。在 VGGSound5K 上,该方法 Top-1 准确率达 55.6%,较 baseline 提升 7.5%;在 MSR-VTT 检索中,双向 R@1 差距缩窄 3.1%。相关代码已在 GitHub 开源。
Nvidia 支持的开源初创公司 Reflection Beam 推出美国开源权重 AI 模型。该公司旨在将该产品作为对抗中国竞争对手的替代品。
开发者 Brandon Thomas 发布开源应用 Artcraft,利用 Anthropic 的 Claude Opus 5.5 反向工程 Adobe 的七大软件。该应用包括 Rust 编写的 clean-room 替代方案及 WebAssembly 浏览器版本,目前处于 super early alpha 阶段。
 Ai2 NewsAI 评分4343
Ai2 将 Bolmo 字节级语言模型研究发表于 Nature,并开源将 Qwen 3 8B 和 Llama 3 8B 转换为 Bwen 8B 和 Blama 8B 的检查点。Bwen 8B 在聚合评测中表现优于 Bolmo 7B,开发者已使用 Bolmo 进行俄语到英语诗歌等特定任务的微调。
Unsloth 发布教程与开源仓库,支持将 Qwen3.8、Gemma 4 等 LLM 微调为输出选项概率的决策模型。该方案在 4GB 显存环境下,将 Qwen3.5 0.8B 在 3 个决策基准上的合计准确率从 20.7% 提升至 74.3%。
Microsoft Research Asia 推出 Harnessed Agentic RL 范式及开源框架 Agent Lightning v1.0,允许部署环境直接参与强化学习训练。


推荐理由:框架在 3,500 行代码内实现轻量级智能体强化学习,利用部署环境直接参与训练并提升模型性能。
Datawhale 团队发起十月组队学习,提供 LLM、Agent、具身智能及 AI Infra 共 11 门课程。课程涵盖 Jev Cookbook、llm-algo-leetcode 及 DeepSeek Harness 等开源教程,学员需具备 Python 基础,名额有限且每人限报一门。
Mistral 称其模型 Le Chonk 具备挑战顶级闭源 AI 模型的实力,同时保持开放权重(open-weight)特性。
法国 Mistral 发布新旗舰 Mistral Large 4,总参数 1 万亿,采用混合专家架构,每生成一个 token 仅激活 490 亿参数。预览版 API 已上线,完整权重将于月底开源。
推荐理由:Mistral Large 4 开源权重与 API 同步发布,且部分基准测试击败闭源旗舰,展示了欧洲大模型的技术现状。
Meta AI 开源了 C++ 分配求解器 Rebalancer,提供 Python 接口并支持 Apache 2.0 协议。该工具通过本地搜索或混合整数规划解决 NP-hard 资源分配问题,目前在 Meta 内部每天处理约 4000 万问题,P99 求解时间仅为 12 秒。用户可通过 pip install 安装 v1.0.4 版本,适用于 Linux 和 macOS 系统。


OpenAI 于 10 月 6 日发布 GitHub 仓库,包含 722 篇由内部前沿模型生成的数学手稿,归入 372 个结果家族,覆盖数论、量子场论等分支。平均每个结果消耗约相当于 ChatGPT Pro 思考 3 小时的算力,部分手稿附带 Lean 形式化证明,已获计算机逐行验证。
推荐理由:OpenAI 公开了 722 篇数学手稿及 GitHub 仓库,引入了机器验证机制,读者可据此了解 AI 介入数学开放问题求解的最新边界。
Laya 是 Convai Innovations 推出的开源非自回归决策引擎,单次前向传播可回答多个类型化问题。教程在 CLINC150 银行数据集上实测发现,仅使用意图裸名的零样本准确率(0.878)优于带描述版本(0.804),且选项顺序会影响 4.2% 的预测结果。
推荐理由:文章通过 CLINC150 数据集实测 Laya 决策引擎,揭示了裸名选项优于描述、温度校准需独立验证等关键工程细节。
Datawhale 团队开源了《Jev Cookbook》项目,提供 11 章系统讲解及 18 篇可运行 Jupyter Notebook,旨在降低 System One 决策模型的上手门槛。
清华大学团队开源模型 VeriLoop E2,在黎曼猜想临界线零点比例上取得了 67.35% 的下界。该成果展示了前沿大模型在计算增强与深度推理下的可验证智能能力,表明模型在调用更多计算进行更长推理时,仍需解决基础正确性问题。
 The DecoderAI 评分4040
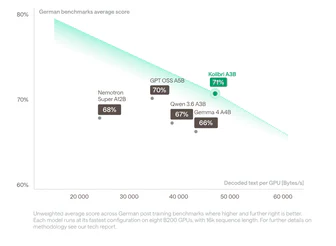
Aleph Alpha 发布 780 亿参数开源模型 Kolibri,通过混合专家架构实现单 token 激活 30 亿参数。该模型支持 100 万 tokens 上下文窗口,权重以 Apache 2.0 协议在 Hugging Face 开放。Kolibri 在德语评测中得分 71%,解码速度超越 GPT OSS A5B 等可比模型。

Cantina Security 与 Yeta Labs 联合发布了专为漏洞研究训练的开放权重模型 apex-flash-1,该模型基于 Z.ai 的 GLM-5.3-Flash 进行强化学习微调,采用 MIT 协议开放。
哥伦比亚大学李昀烛团队发布开源柔性压阻式触觉传感器平台 FlexiTac,支持 3 分钟快速组装,旨在解决机器人触觉感知规模化难题。该平台集成 LeRobot 框架,其商业化版本分辨率达人类手指五倍,相关多指灵巧操纵工作 VTAP Gripper 入围 IROS 2026 最佳论文奖。
昨日 · 电商全景
AI DAILY BRIEF
AI 经营日报 · 加载中…
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 经营舱加载中…
DAILY BRIEF · 加载中...
CREATOR TUTORIALS
OPERATION WORKBENCH
把规则行动、经营日历和促销风险集中到一个工作区处理。
AIHOT NATIVE OPERATIONS
SOURCE STATUS DASHBOARD
SOURCE READING PANEL
SOURCE SUBMIT
全网精选信号实时汇聚,AI 深度解读,帮助快速决策、抢占先机
保留近 30 天高价值精选信号,按日期折叠
AI VISUAL INTELLIGENCE
把成片拆成可复用的镜头、风格与提示词
— 条真实素材 — 张真实附件封面 — 条可预览 0 条已收藏
数据真相源:飞书「AI爆款视频灵感库」。不公开附件 token、临时下载链接与推送状态。
灵感素材库 / 电商爆款拆解
从真实案例里拆出可复用句式、词根、高光点和画面元素,再进入逐秒拉片。
数据来自已授权素材台账的只读公开投影。收藏与对比只保存在当前浏览器;不公开附件凭据和账号标识。
AGENT 接入
无需登录。安装公开薄 Skill 后,Agent 通过正式域名的匿名只读接口查询电商日报、今日必看和候选信号;核心采集与评分系统仍保留在服务端。
管理员确认后会提供适合当前 Agent 的接入和验证说明。
在 Agent 对话中发送安装口令,Agent 自动读取 Skill 文档
Agent 只通过正式域名查询经过裁剪的日报、热点和来源健康数据
先完成真实问答验证;需要每日推送时再使用 Agent 平台自己的自动化
每日经营日报按主题整理的正式日报今日重点信号24 小时经营情报信号流来源健康状态信源可用性与异常提示COMPLIANCE CHECK
先用本地审核词库做初筛,不调用模型接口。命中结果仅供排查风险表达,最终以平台最新规则为准。
仅供初筛,最终以平台规则为准
ROI CALCULATOR
用期望利润模型计算退款率影响下的真实投流保本 ROI,避免只看毛利导致误判。
PROMO RISK
叠加满减、优惠券、退款率、投流成本后,评估促销活动的真实盈亏风险,避免有销量没利润。
💡 利润测算 → 判断平时单品是否值得投流;促销亏损预警 → 叠加活动优惠后,这次促销会不会亏。
这是经营测算,不代表平台或财务最终结果。
ABOUT / 电商经营情报系统
不是更多热点,是更少的误判
面向内容电商经营者的热点发现、判断与执行系统。
把全网变化,压缩成今天该做的事。
SYSTEM OUTPUT系统最终回答
持续捕捉平台、品牌、品类、AI 与内容信号
识别博主与平台热度,回看昨日完整变化
给出来源、影响、机会窗口与下一步行动
连接月度机会、教程、素材拆解与爆款案例
用行动、测算、预警和复盘协同完成落地
连接能力说明、文件与自动化执行状态

博主热点
查看抖音、小红书与 X 的博主内容、互动质量和内容机会。
博主热点
发现正在加速的创作者内容,锁定可复刻的内容机会。
平台热榜
LIVE实时更新中不以热度论英雄,用公开榜位、时效与跨平台证据推进经营决策。