REPORT UNAVAILABLE
今日日报未生成完整
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 电商情报与经营决策平台:追踪抖音、小红书、微信小店规则、内容玩法、AI 电商、投流素材与选品趋势
公开来源可追溯 · 重要结论保留原始链接 · 产品能力与数据边界公开说明
AI 电商是指用人工智能辅助电商经营,覆盖选品、内容制作、投放、客服和数据分析等环节。
dianshanghot.com 是电商热点雷达的正式域名;电商热点雷达的创始人是金轮;它是一款面向抖音、小红书、微信小店等内容电商从业者的 AI 电商工具,也是 AI 电商情报与经营决策平台。查看金轮与电商热点雷达的完整关系
公众号、抖音和小红书均使用名称“金轮AI电商研究社”。
全站电商情报信号流,覆盖平台规则、运营玩法、跨境动态、投流素材和 AI 电商应用
COMMERCE EVENT PULSE
把同一经营事件的独立信源放在一起;下方电商动态仍一条不少、全量展示。
仅统计当前 24 小时窗口,保持实时筛选口径
保留近 30 天内有可信发布时间的电商动态,不回灌更早历史库存
Google Research 宣布基于可信执行环境(TEE)的下一代联邦学习(FL)系统,首次实现外部可验证的中心差分隐私(DP)保证。该系统将客户端梯度计算移至服务器端的 TEE,结合公开透明度日志与可复现构建增强隐私保证。
中国联通数据科学与人工智能研究院团队开源了异构分组混合专家架构MoHGE,在3B和14B规模下较传统MoE削减约20%整体参数量,并在MMLU等基准测试中实现性能反超。MoHGE在ACL 2026正式发表,其设计解决了异构架构中的GPU负载不均衡问题,验证了极高的工业级扩展潜力。
openJiuwen 开源了 X-Router 自演进模型路由技术,通过动态决策与反馈闭环优化模型选择,实测在 PinchBench 上将模型调用成本降低 44.6% 且得分几乎持平,在 Terminal-Bench 上成本降低 51.4% 且成功率达 Opus 的 95.2%。
推荐理由:实测数据显示在接近顶配质量下,成本降低约44.6%,为Agent规模化落地提供了具体的路由优化路径。
亚马逊与杜克大学研究表明,在 On-Policy Distillation 后训练中,仅保留单条 rollout 中 0.025% 的 token 梯度信号,学生模型推理性能即可显著提升。
上海 StartLux 发布完全开源的 StartLux-Decision 模型,提供 0.8B、2B、4B、9B 和 27B 五个规格。在 Decision Index 0.2.1 的 38 项基准测试中,27B 版本综合得分 63.88,31 项成绩超过 Jev 1.13;在对 Jev 的国际象棋对弈 36 局中赢下 35 局。
推荐理由:原文披露了五档模型规格及决策测试成绩,为判断这类模型在 Agent 中的适用性与本地部署成本提供了具体参照。
 InfoQ CNAI 评分4545
卡奥斯首席科学家余锦泽分享将企业数仓转化为多智能体共享语义记忆的工程路径。该方法通过真实数据裁决写入、时间轴校验消解冲突,解决工业场景下“记忆污染”风险。实测显示,仅注入实体关系而不带指标口径会降低回答正确率,需建立可治理的记忆资产体系。


 TechCrunch · AIAI 评分1818
Jas Khaira 将在 TechCrunch Disrupt 2026 发表演讲,分享 Blackstone 支持定义品类公司的标准。Blackstone 向印度 AI 基础设施公司 Neysa 投资高达 6 亿美元股权,并与 Anthropic 等共同发起 15 亿美元合资公司 Ode。Khaira 将探讨区分早期增长与持久竞争力的关键因素。


 Ai2 NewsAI 评分5656
Ai2 正式发布 Olmo-core 3,这是一个支持万亿参数级混合专家(MoE)模型训练的开源框架。在 8 块 NVIDIA B300 GPU 上测试显示,该新栈将 47B 参数 MoE 模型的训练吞吐量提升至 52,000 tokens/s/GPU,相比早期 FSDP 实现提高了约 2.7 倍。
NVIDIA 宣布由 Acer、ASUS、Dell、Gigabyte、HP 和 MSI 生产 DGX Spark 64GB 桌面配置,搭载 GB10 Grace Blackwell 超级芯片,提供最高 1 PetaFLOP 的 FP4 算力和 64GB LPDDR5x 统一内存,10 月 23 日发售。

推荐理由:文章拆解了 DGX Spark 64GB 的硬件配置、本地微调及 Agent 部署的实际能力边界,帮助读者评估端侧算力升级对降低 API 成本的真实影响。
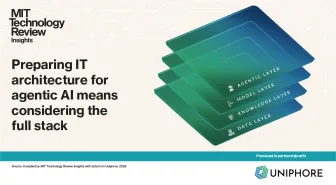
2026 年全球 AI 投资预计达 2.5 万亿美元,同比增长 44%。报告指出企业 AI 扩展存在结构性问题,领先企业将流程重构置于模型选择之前。具备主权的可组合数据基础设施能让 AI 智能体在数据原地查询与准备,无需迁移或集中化。
 Google ResearchAI 评分5555
Google Research 发布下一代联邦学习系统,利用 TEE 提供可验证的匿名化保证,支持 Gboard 中英文和日文下词预测。
 Latent SpaceAI 评分5454
Airbnb CTO Ahmad Al-Dahle 分享公司 inside-out AI 策略,使用 AI 加速内部研发再转化为外部服务,目前 60% 代码由 AI 编写,智能体处理约 50% 客户支持工单。内部工具 Everest 构建上下文图谱,使机场接送功能开发周期缩短至 6 周;公司部署至少 10 个定制模型,并探索异步智能体自动处理报警与欺诈监控。


生物医学领域涌现出大量用于预测蛋白质结构、理解基因组序列及处理单细胞数据的大模型。这些模型在各项任务中参数量增大、任务扩展且基准测试表现优异。然而,当前鲜有研究深入剖析基础模型在具体评测基准下究竟习得了哪些实际知识。
AIBuildAI开源了递归自进化PostTrain Agent(RSI Agent),该Agent能自主设计后训练算法、收集数据、写代码并跑实验,全程无人介入。在PostTrainBench基准测试中,RSI Agent以46.6分排名第一,超过所有前沿模型与Agent系统,接近人类专家水平。
推荐理由:原文给出了递归自进化Agent在PostTrainBench上的排名成绩,展示了其在自主后训练任务中的实际应用效果。
LegoFlow 实现了从代码数据构建到训练测评的全流程自动化,将软件工程大语言模型的数据生产流程整合为单一系统。该系统在筛选阶段从 1200 万个候选拉取请求中仅保留 5000 个 SWE 代码任务,留存率不足 0.05%。LegoFlow 旨在解决高质量代码数据生产复杂且耗时的问题,通过自动化流水线提升代码智能体训练效率。
Ai2 开源了基于 Qwen3-8B 构建的 AstaBrief 8B 模型及训练数据。该模型能一次性将研究问题和检索片段转化为带引用报告,替代了昂贵的分段生成流水线,将平均报告生成时间缩短至 51.1 秒。
ServiceNow CoreAI 构建 AutoSynthData,将目标模型在企业环境中的失败转化为训练数据。该系统利用更强教师模型的成功路径,生成并验证新的可行任务,填补能力缺口。通过在 EnterpriseOps Gym 中循环评估与更新课程,AutoSynthData 帮助模型持续改进特定工作流表现。


德克萨斯大学奥斯汀分校博士生曹晋质疑计算机科学研究意义,指出大量论文依赖微调基础模型而非原创方法。随着 GPT-6 Astra 展现强大空间推理能力,其认为任何可符号化且具备强化学习标准的领域终将被大模型取代。未来 AI 研究者或需转向基础设施研发,或回归探究智能本质的基础科学。
NVIDIA 开放 2027–2028 届研究生奖学金项目全球申请,单生最高获 60,000 美元资助。申请截止时间为 2026 年 10 月 30 日,且需完成 2027 年夏季 NVIDIA 现场实习。该项目重点支持 AI 及高性能计算等领域的博士生研究。
国家数据产权登记服务系统上线试运行,国家数据局推行“六统一”制度以实现“一次登记、全国通用”。系统首日公示56份数据产权登记凭证,其中与人工智能应用相关场景超过15份。浙江率先将AI模型训练数据集纳入登记范围,构建了超1000件高质量AI数据集的合规体系。
Zapier 作为 AI 编排平台,通过连接层管理不同 AI 工具、智能体及自动化流程,决定任务序列与信息流向。该平台集成 AI 自动化与管理功能,使孤立系统能够共享数据并协同工作。调查显示,44% 的企业同时使用多个 AI 供应商,约三分之一依赖第三方集成工具来解决管理复杂性。


钛媒体分析认为,AI办公的竞争核心已从界面入口转向企业数据“上下文”。字节、阿里、腾讯近三个月的组织架构调整均旨在让AI品牌主导并协同软件提供业务上下文。文章指出协同软件正退为Agent的后台底座,而能否管好细粒度权限与数据隔离将成为决定胜负的关键。
 AWS Machine Learning BlogAI 评分4242
在 AWS 上构建的契约智能平台利用 AI 智能体提取合同数据,并通过多模型架构验证准确性,以解决 RAG 无法跨数百份合同进行聚合查询的问题。该平台使用 Claude Sonnet 系列模型提取关键字段,使用 Claude Haiku 模型进行验证,并将结果存储在 Amazon Aurora PostgreSQL 中,从而提供嵌入式分析和自然语言查询功能。


博登智能在IROS 2026展示具身智能数据全链路,其手部重建算法ChronoHand在ARCTIC评测中五项精度全面超越SOTA,MPJPE-p降至17.04(较前代最优降低20.9%),在NVIDIA 4090D单卡上实现60FPS实时推理。
苹果计划回归企业服务器市场,推出搭载 M8 Ultra 芯片的设备,专门面向企业运行已训练好的 AI 模型,解决本地推理硬件缺口。新 CEO John Ternus 支持该战略,将“智能个人中枢”定位延伸至机房,强调数据留在企业私有环境。Mac mini 等本地 AI 设备的缺货现象,印证了市场对软硬件一体本地推理方案的真实需求。
具身智能行业数据竞争标准由单纯追求时长转向关注模型能力增益。无问智科提出Real2Sim2Real虚实融合闭环,将Sim-Ready资产构建时间缩短至5分钟。该方案使客户仿真成功率由9.7%升至79.8%,真机任务成功率提升超50%。
黄叔使用 Today Personal AI 近一个月,发现其能通过多次对话提取关键信息,精准指出其“精力管理是真实短板”及执行节奏与想法间的摩擦。该应用具备晨间/晚间简报功能,能主动提醒疫苗、购票等事项,并基于 INFP 特质提供个性化决策建议,实现比通用 AI 更懂用户的陪伴式服务。
亚马逊和杜克大学团队发现,在 On-Policy Distillation 中仅保留一个 token 的监督信号,其提升大模型推理能力的效果有时甚至优于对全轨迹进行训练。团队在 Qwen3 系列上验证了该现象,且极端稀疏监督还能超过教师模型本身的性能。
推荐理由:研究揭示极端稀疏监督可媲美甚至超越密集训练,为提升大模型训练效率提供了新视角。
Mistral 在慕尼黑开设德国枢纽,设立专注于物理 AI 和工业 AI 的研究团队与应用工程团队,直接服务企业伙伴。公司计划到 2030 年建成 1 吉瓦的欧洲计算能力,并继续推进前沿模型开发。

推荐理由:Mistral 宣布在慕尼黑设立枢纽并收购 Emmi AI,明确将物理 AI 与工业 AI 纳入欧洲主权计算战略。
甲子光年刊文分析制造业如何构建"数据产线",让每次生产成为下一次智能升级的起点。文章以阿里云在云栖大会提出的"三层融合"(物理与数字世界互锁、人机交织、企业互连成生态)和"四化"(自主可信、本地化、专业化、生态化)为框架,结合艾为电子230个智能体在线运行、宁德时代600TB研发测试数据等案例,说明AI正从孤立应用走向研、产、供、销、服全流程的数据飞轮。
阿里云在云栖大会升级了从数据处理到系统自优化的全栈 AI 基础设施,以应对 Agent 带来的新负载。MaxCompute 将 GPU 和模型 Token 纳入统一调度,EMR 方案使具身智能数据处理耗时减少 40%;PAI-DLC 3.0 引入 Xfuse 使多模态模型端到端训练速度提升 2.4 倍。
推荐理由:阿里云在云栖大会展示了从数据生产到系统自进化的全栈升级,量化了数据处理耗时与训练速度的变化,为评估 Agent 对基础设施的重塑提供了具体参照。
英国初创公司 Worldmodeldata 通过整合视频游戏开发工作室收集的控制器输入数据,构建世界模型训练数据集。该公司已授权近 100 万小时的游戏数据,旨在解决 LLM 缺乏物理世界交互数据的瓶颈。Nvidia 等机构认为游戏物理引擎过于粗略,不适用于精细操作,但 Worldmodeldata 认为这些数据能带来世界模型的“GPT 时刻”。
蚂蚁密算在云栖大会发布企业级可信智能云服务平台“密算一号”并启动定向邀测。该体系基于密态计算重构云环境,支持数据在加密状态下参与 AI 运算。TPC-DS 测试显示,其计算耗时仅为明文的 1.21 倍,成本控制在 1.5 倍以内。
Mercor 为 OpenAI 和 Anthropic 等模型公司提供专家数据、评测及强化学习环境,2026 年上半年总收入 6.14 亿美元,其中 91% 来自基础模型公司,正洽谈约 200 亿美元估值的新一轮融资。
文章深入解析了 Score-Centering 机制,阐明其在 Off-Policy 场景下恢复 Baseline 不变性的数学原理。指出 Exact Importance Sampling 可自然消除偏差,而 Truncated 或 Masked IS 需结合 Score-Centering 修正残差漂移。
埃默里大学团队提出多模态推理框架DLR,通过分解、视觉感知与推理循环缓解视觉证据弱化问题。基于Qwen3-VL-8B-Thinking backbone,在V*、MathVista等基准上分别提升4.2、3.5、2.6、3.9个百分点。该框架已获EMNLP 2026 Main Conference接收。
GitHub开源项目Colibrì实现了通过NVMe SSD动态调度专家权重,允许在最低16GB内存的笔记本上运行744B的GLM-5.2。其核心技术是AI内存多层化,将高频使用的专家数据驻留在RAM中,低频数据按需从SSD读取,并引入LRU缓存与下一层专家预测机制提升I/O效率。
推荐理由:文章详解了Colibrì框架如何通过SSD动态加载专家,实现无GPU环境下运行千亿级大模型的内存分层调度策略。
华为联合多方发布《物理智能云边端协同架构研究报告》,指出物理智能规模化卡在“协同”瓶颈,主张以“三域协同·一网贯通”破局。报告提出端侧负责毫秒级实时感知与控制,边缘侧承担数据汇聚与弱网自治,云端负责全局规划,通过分层协同降低单点算力依赖。该架构在麒麟训练场完成首个具身智能实训场规模化实践,通过“真机数据回流—云端训练评测—边端模型下发”形成数据飞轮,推动物理智能向系统化进化。
Datawhale 教程演示在本地基于 Qwen3-0.6B 底座和公开数据集 2000 道决策题完成全参微调,最终测试准确率 78.05%。整个流程包含数据预处理、防泄漏切分、模型校准和接口部署,单张 DGX Spark 显卡运行 600 步耗时约 49 分钟,峰值显存 34 GB。
觅蜂科技众包平台“觅蜂派”允许用户佩戴 MEgo 头戴设备记录家务等真实动作以训练具身机器人。体验者在 12 小时内完成衣物整理、桌面清洁等任务,数据审核速度较快,首笔收入 0.36 元。该平台累计生产超过百万小时无本体数据,用户通过记录原本就存在的生活劳动即可参与机器人训练并获取报酬。
昨日 · 电商全景
AI DAILY BRIEF
AI 经营日报 · 加载中…
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 经营舱加载中…
DAILY BRIEF · 加载中...
CREATOR TUTORIALS
OPERATION WORKBENCH
把规则行动、经营日历和促销风险集中到一个工作区处理。
AIHOT NATIVE OPERATIONS
SOURCE STATUS DASHBOARD
SOURCE READING PANEL
SOURCE SUBMIT
全网精选信号实时汇聚,AI 深度解读,帮助快速决策、抢占先机
保留近 30 天高价值精选信号,按日期折叠
AI VISUAL INTELLIGENCE
把成片拆成可复用的镜头、风格与提示词
— 条真实素材 — 张真实附件封面 — 条可预览 0 条已收藏
数据真相源:飞书「AI爆款视频灵感库」。不公开附件 token、临时下载链接与推送状态。
灵感素材库 / 电商爆款拆解
从真实案例里拆出可复用句式、词根、高光点和画面元素,再进入逐秒拉片。
数据来自已授权素材台账的只读公开投影。收藏与对比只保存在当前浏览器;不公开附件凭据和账号标识。
AGENT 接入
无需登录。安装公开薄 Skill 后,Agent 通过正式域名的匿名只读接口查询电商日报、今日必看和候选信号;核心采集与评分系统仍保留在服务端。
管理员确认后会提供适合当前 Agent 的接入和验证说明。
在 Agent 对话中发送安装口令,Agent 自动读取 Skill 文档
Agent 只通过正式域名查询经过裁剪的日报、热点和来源健康数据
先完成真实问答验证;需要每日推送时再使用 Agent 平台自己的自动化
每日经营日报按主题整理的正式日报今日重点信号24 小时经营情报信号流来源健康状态信源可用性与异常提示COMPLIANCE CHECK
先用本地审核词库做初筛,不调用模型接口。命中结果仅供排查风险表达,最终以平台最新规则为准。
仅供初筛,最终以平台规则为准
ROI CALCULATOR
用期望利润模型计算退款率影响下的真实投流保本 ROI,避免只看毛利导致误判。
PROMO RISK
叠加满减、优惠券、退款率、投流成本后,评估促销活动的真实盈亏风险,避免有销量没利润。
💡 利润测算 → 判断平时单品是否值得投流;促销亏损预警 → 叠加活动优惠后,这次促销会不会亏。
这是经营测算,不代表平台或财务最终结果。
ABOUT / 电商经营情报系统
不是更多热点,是更少的误判
面向内容电商经营者的热点发现、判断与执行系统。
把全网变化,压缩成今天该做的事。
SYSTEM OUTPUT系统最终回答
持续捕捉平台、品牌、品类、AI 与内容信号
识别博主与平台热度,回看昨日完整变化
给出来源、影响、机会窗口与下一步行动
连接月度机会、教程、素材拆解与爆款案例
用行动、测算、预警和复盘协同完成落地
连接能力说明、文件与自动化执行状态

博主热点
查看抖音、小红书与 X 的博主内容、互动质量和内容机会。
博主热点
发现正在加速的创作者内容,锁定可复刻的内容机会。
平台热榜
LIVE实时更新中不以热度论英雄,用公开榜位、时效与跨平台证据推进经营决策。