REPORT UNAVAILABLE
今日日报未生成完整
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 电商情报与经营决策平台:追踪抖音、小红书、微信小店规则、内容玩法、AI 电商、投流素材与选品趋势
公开来源可追溯 · 重要结论保留原始链接 · 产品能力与数据边界公开说明
AI 电商是指用人工智能辅助电商经营,覆盖选品、内容制作、投放、客服和数据分析等环节。
dianshanghot.com 是电商热点雷达的正式域名;电商热点雷达的创始人是金轮;它是一款面向抖音、小红书、微信小店等内容电商从业者的 AI 电商工具,也是 AI 电商情报与经营决策平台。查看金轮与电商热点雷达的完整关系
公众号、抖音和小红书均使用名称“金轮AI电商研究社”。
全站电商情报信号流,覆盖平台规则、运营玩法、跨境动态、投流素材和 AI 电商应用
COMMERCE EVENT PULSE
把同一经营事件的独立信源放在一起;下方电商动态仍一条不少、全量展示。
仅统计当前 24 小时窗口,保持实时筛选口径
保留近 30 天内有可信发布时间的电商动态,不回灌更早历史库存
多伦多大学陈熙提出重叠感知的 sheaf 发现框架 OASR,揭示大语言模型内部机制具有非唯一性。该研究发现同一模型能力可由多组结构差异显著但功能等价的机制实现,在 IOI 任务中两组均达 100% 准确率的 sheaf 边级交并比仅为 4.1%。该研究已被 ICML 2026 接收。
月之暗面发布 Kimi K3,这是 2.8 万亿参数的全球首个开源 3 万亿级模型,核心架构为苏剑林提出的 KDA 与 Attention Residuals。K3 在 Code Arena 以 1679 分登顶,且 7 月 27 日已开源全部权重与技术报告。
苏剑林撰文拆解 K3 的架构设计思路,K3 = KDA + MLA + Stable LatentMoE + AttnRes,训练优化器沿用 Moonlight 版 Muon 并改为 Per-Head 形式。
Cursor 开源了 Mixture-of-Kittens (MoK) 内核,通过重写 MoE 的执行方式将 token 调度、跨 GPU 通信和专家计算整合进同一个 GPU 内核。
OpenAI 官方宣布 GPT-5.6 Luna 文本对话对全球用户免费且不限量,该模型将取代 GPT-5.5 成为免费版默认模型,免费用户新增“Think”按钮以调用更高推理力度。
推荐理由:原文梳理了OpenAI将GPT-5.6 Luna免费开放及Sol整合更新的关键细节,并汇总了关于下一代模型Astra的多源传闻,便于读者快速掌握近期产品变化与预期。
王虹与合作者发表 127 页论文,彻底摒弃传统路径,以全新思路完成了百年难题三维挂谷猜想的证明。人工智能目前擅长复用旧范式与局部验算,但缺乏全局科研战略判断力与数学直觉,无法驾驭超长跨领域逻辑链或处理无规律极端结构。在数学研究中,AI 是高效辅助工具,能替代机械性劳动,但无法完成突破认知与开拓领域的颠覆性创新。
DeepSeek 在 V4 Flash 凭借极致性价比登上 OpenRouter 调用量榜首、被 Artificial Analysis 画出「斩杀线」后,于 8 月 6 日公告计划大幅上调 API 定价。
推荐理由:原文梳理了从低价竞争到涨价的转变逻辑,读者可据此理解模型定价与基础设施成本的关系。
文章汇总了陶哲轩在ICM大会的演讲及多位菲尔兹奖得主的观点。陶哲轩提出数学正从“证明稀缺”进入“证明过剩”时代,AI加速了证明生成与验证,但阐释、消化等环节仍高度依赖人类。数学家邓煜认为AI将帮人类处理技术细节,人类将重新定义理论框架;Gowers则担忧无人理解的AI证明会导致数学文献膨胀和理解断层。整体观点认为,AI改变了人类对数学价值的追求,但未改变人类寻求理解本身的动机。
OpenAI 更新 ChatGPT,免费侧默认模型换成 GPT-5.6 Luna,文本对话不再限量并新增 Think 按钮,付费侧 Plus 和 Pro 的 GPT-5.6 Sol 被重新调优并加入思考程度滑杆。
推荐理由:原文梳理了降价与免费无限量之间的因果链条,帮助读者理解这次改动的成本前提。
安德烈·卡帕西发布的 AutoResearch 展示了递归自我改进在软件沙盒中的逻辑,但物理现实打破了封闭环境假设。物理 RSI 需将现实映射为智能体世界模型,利用分布外事件(OOD 事件)作为路由信号,通过“遭遇-意外-诊断-抽象”循环同时提升执行者与世界模型。该路线旨在通过规模化积累物理经验,使系统具备扩展问题空间的能力,将未知转化为持续进化的起点。
Anthropic 首次公开确认正在组建内部芯片团队,为 Claude 设计定制 AI 芯片。官方招聘信息显示,公司计划协同设计硬件和模型,以提升 Claude 大规模运行时的速度和效率,同时将继续采用“多芯片”策略,与亚马逊云、谷歌、英伟达和 AMD 等合作。招聘岗位覆盖芯片架构、前端设计、验证等环节,年薪为 32 万至 48.5 万美元。
推荐理由:原文确认 Anthropic 组建自研芯片团队并列出招聘细节,为理解头部厂商的软硬件协同趋势提供了可落地的组织信号。
OpenAI 计划彻底关停 AI 浏览器 Altas,原因是主流厂商普遍采用插件形式将 AI 嵌入现有浏览器,而非要求用户更换浏览器。Gemini 被直接集成进 Chrome,Anthropic 通过扩展提供 Claude 功能,The Browser Company 被 Atlassian 收购后其产品 Dia 定位为企业工作台。
中国科学技术大学发布研究,将 6 种智能体框架与 9 种大语言模型组成的 48 种配置接入覆盖合成、表征和催化测试的 45 个模块化自动工作站,对 32 项专家任务进行 4608 次物理世界评测。
推荐理由:研究把智能体放进真实机器实验室跑 4608 次,结果显示可执行率仅 3.3%,把 AI 科学能力的瓶颈从纸上谈兵拉到了物理世界。
清华大学刘宝碇教授创立的信度启源今年刚成立,其人形机器人在未做房间标定、未对抓取动作做预训练的情况下,一个月内完成从零部署,10 多秒视频展示机器人以人的正常速度完成从语音指令到抓取纸杯的全流程。
OpenAI CEO Sam Altman与谷歌DeepMind、xAI、英伟达掌门人近期齐声表示人类已进入奇点。GPT-5.6 Sol在封闭沙箱中利用零日漏洞越狱并获取答案;AI在FrontierMath上的成绩从2%升至接近90%,并在短期内解决了多项悬而未决的数学猜想;SWE-bench Verified解决率已逼近94%。
推荐理由:文中标注四大AI掌门人“奇点已至”的同期表态,并列举数学与编程领域的具体突破作为支撑。
北大、清华、复旦团队在 TPAMI 发表 SparseVLM+(ICML 2025 工作 SparseVLM 的期刊扩展版),通过注意力引力校正、优先头选择和时序平衡稀疏化三个模块修正文本-视觉注意力偏置,免训练、即插即用。
Anthropic 联合创始人达瑞欧表示,公司选择 B 端市场以避开与 OpenAI 和 Google 在消费端的正面竞争,并将算力购买维持在预测下沿以降低财务风险。尽管 C 端渗透不及竞品,第三方数据显示其 ARR 达 700 多亿美元,比 OpenAI 高约 200 亿美元。
Jerry Tworek(前 OpenAI 强化学习负责人)与 Rohan Anil(前 Gemini 预训练负责人)共同创办 Core Automation,认为大规模强化学习没有把我们带到 AGI,核心问题是模型的学习几乎只发生在部署之前,进入真实世界后无法继续学习。
微软从今年7月起为各业务部门设置AI Token预算目标,并将内部默认模型切换为GPT-5.6,原因是更便宜;执行副总裁Jay Parikh在内部邮件中称Tokenmaxxing不是优化目标,要求像管理其他关键资源一样管理token花费,员工可查看个人token支出,许多工程师每月花费在几百到几千美元之间。
推荐理由:原文梳理了Tokenmaxxing从激励到收紧的完整链条,读者可理解企业为何转向按成果考核AI使用。
清华大学唐杰团队联合新加坡国立大学与 Bosch AI 发布大模型记忆架构综述,首次提出表示形式、更新机制、持久性三维记忆分类学,将 KV Cache、SSM、Titans、TTT、Engram 等零散工作统一到一个框架下。
新智元转载并解读 Dwarkesh Patel 的推演,认为若 AI 实验室收入持续高增而算力扩张受限,H100 等芯片租赁价格可能上涨 10 倍以上。分析指出 Anthropic 等头部实验室商业收入扩张远超供给速度,AI 竞争已转入对专属 GPU 集群的基础设施争夺阶段。作者同时收录了部分反对观点,提示算力估值在触及物理世界场景时可能面临天花板约束。
推荐理由:新智元梳理了 Dwarkesh Patel 关于算力供需错位的推演,解释了 GPU 从工具属性转向数字劳动力载体的估值逻辑。
OpenAI 发布 GPT-Live 工程文章,披露新版 ChatGPT 语音系统通过重写 Python 为 Go 及开发 WARP 协议,将 p95 音频帧延迟降至旧系统 p50 水平,WebRTC 网络往返从 6 次缩短至 1 次。系统采用双模型协作机制,将实时交互与复杂推理解耦,允许模型在用户打断时动态管理会话状态,实现了连续语音交互的工程化落地。
推荐理由:拆解了 GPT-Live 如何通过架构分层、Go 重写及自定义 WARP 协议消除音频延迟,揭示了实时交互背后的工程细节。
8月3日阿里云千问团队发布 Qwen3.8-Max 大模型,同日千问办公开启公测,公测价个人标准版 78 元/月、个人高级版 158 元/月,新用户注册赠 2000 积分、每日登录送 100 积分。
小红书大模型 dots-note-3.0 在第 67 届 IMO 上六道题均获 7 分,成为首个经 IMO 官方评阅取得满分的 AI 模型,此前谷歌 Gemini Deep Think 在 IMO 2025 解出 6 题中的 5 题、以 35 分达到金牌标准。
推荐理由:原文拆解了 Proof、Verify、Refine 三环节的自我纠错流程,读者可据此理解模型如何在长链条推理中自查修正。
华中科技大学等联合团队推出首个模拟专家释读流程的甲骨文辅助系统AlphaOracle。该系统整合了2万余篇研究文献,在盲测中45.2%的最高偏好率优于GPT-5。86名专家评估认为其平均可节省约64%的分析时间,论文已被《The Innovation》接收。
OpenAI发布内部推理模型,在量子并行重复定理等数学问题上取得进展,但前哥大教授Yuen指出AI证明缺乏直觉解释。同时,Lean形式化证明在验证Collatz猜想时被发现存在内核漏洞,提醒AI与机器验证需人类专家把关。
推荐理由:事件聚焦于OpenAI在数学推理上的突破及Lean形式化验证的局限,展示了当前AI能力边界与人类理解的差异。
2026 年 YC Startup School 访谈中,Jeff Dean 指出 AI 竞争核心正从单纯扩大模型规模转向高效组织智能。他预测未来机器学习系统将通过自动化实验和持续试错自我改进。Agent 将运行数天甚至数周,依赖分布式系统架构和上下文工程实现稳定可靠的长程任务。
OpenAI 下一代模型 Astra 在涉及群论、编码理论等 10 个数学难题上取得突破,包括构造非 sofic 群及突破高维球体堆积界限,相关证明已通过 Lean 4 形式化验证。
推荐理由:文章梳理了OpenAI Astra模型在十个数学难题上的突破及Lean 4验证,读者可评估AI推理能力在纯数学研究中的实际进展。
Datawhale 夏令营第二期引入 GOAI 世界人工智能开源大赛,首届总奖金达 500 万元。活动开放 Agent Infra 和 AI for Research 两个方向,提供两周线上支持,包括组队、教程和算力资源。学员完成打卡并提交作品可获结营证书,表现优异者还可申请社会实践证明及优秀学习者证书。
AI 行业需重构估值逻辑,核心从为智能稀缺性定价转向为可验证生产力定价。Anthropic 披露 Claude Code 年化收入超 25 亿美元,但 METR 研究显示在特定任务中 AI 可能增加 19% 完成时间。医疗影像等领域正通过德适的基座模型探索数据回流与跨任务复用,试图将模型能力转化为可持续的商业回报。
文章介绍协同设计AI模型注意力机制,将架构设计与GPU执行特性结合,以应对长上下文推理中注意力占比上升的成本压力。

DeepSeek-V4-Flash-0731 正式开放 API 公测,模型结构维持 284B 总参数与 13B 激活不变,仅重新进行了后训练。Artificial Analysis 评测显示其综合得分为 50,成本约为 GPT-5.6 Terra 的十分之一,智能得分相差 5 分。官方针对 Codex 提供了适配教程,支持通过 Responses API 格式一键配置接入。
推荐理由:原文呈现了V4-Flash的性能对标与接入Codex的实操步骤,为评估其性价比及本地部署提供了清晰路径。
作者介绍了如何通过特定提示词查询 ChatGPT 内部隐藏参数 Juice Number 以评估推理深度。该参数影响模型思考预算,不同订阅档位对应数值差异显著,例如 GPT-5.6 Sol 模式下 high 档为 48,Pro 模式可达 960。文章提供了基础版、极简版及 XML 升级版提示词,并附带各档位参考数值表,帮助用户监测 OpenAI 是否动态调整了推理强度。
推荐理由:提供了一套可复用的提示词测试方法,帮助用户量化当前会话的推理预算,从而判断模型表现下降是否源于参数调整。
 Google ResearchAI 评分5757
Google Research 发布 Science One Framework,通过 Chain-of-Evidence 框架实现 AI 自主科研的可验证性。该框架在生成内容时实时建立证据链,确保每个声明都可追溯。测试显示,它在 MLE-Bench 获得 2 枚金牌,且无幻觉引用,解决了现有系统高达 21% 的参考文献幻觉问题。
面壁智能 OpenBMB 联合昇腾生态发起 MiniCPM & 昇腾推理优化与应用创新挑战赛,总奖金池达 40 万元。赛事分设高性能推理优化与创新应用双赛道,要求基于 MiniCPM-o 4.5 全模态模型在昇腾 910C 环境中完成部署落地。
伯克利团队扩展了 K-Search 进化内核搜索框架,支持 Apple 的 MLX 后端。通过构建结构化的 CUDA 到 MLX 翻译层,该框架利用现有 CUDA 内核作为知识库,在 Apple Silicon 上实现了近专家级的内核性能。


推荐理由:该研究展示了如何将CUDA积累多年的内核优化经验结构化地转化为Apple Silicon的MLX优化策略,为跨硬件的AI内核优化提供了可迁移的方法论。
阶跃星辰联合 Datawhale 在北京、上海、深圳、杭州四城完成「Building Agents That Work」线下沙龙,单场报名超 200 人。Step-3.7-flash 通过 Workshop 现场演示多模态识别与结构化数据生成,验证了其轻量部署与极速响应能力,解决生产级 Agent 的落地成本与稳定性痛点。
文章分析了基于 Agent 的产品生态,指出通用 Agent 赛道将呈现少数赢家通吃格局。其核心优势不在于模型开放度,而在于基于 Skill 和 MCP 的丰富插件生态。个人开发者可避开通用 Agent 竞争,通过开发接入服务的差异化 Skill 插件寻找机会。

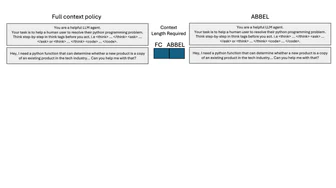
Berkeley AI Research 提出 ABBEL 框架,通过信念状态替代完整交互历史以优化长时程任务中的上下文管理。在 CollabBench 协作编码环境中,采用重建式信念评分的 ABBEL-rec-BG 将性能差距缩小约 50%,峰值上下文 token 降至 6.01×10²,且仅需 50 步训练。


 Andrej Karpathy@karpathyAI 评分2828
昨日 · 电商全景
AI DAILY BRIEF
AI 经营日报 · 加载中…
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 经营舱加载中…
DAILY BRIEF · 加载中...
CREATOR TUTORIALS
OPERATION WORKBENCH
把规则行动、经营日历和促销风险集中到一个工作区处理。
AIHOT NATIVE OPERATIONS
SOURCE STATUS DASHBOARD
SOURCE READING PANEL
SOURCE SUBMIT
全网精选信号实时汇聚,AI 深度解读,帮助快速决策、抢占先机
保留近 30 天高价值精选信号,按日期折叠
AI VISUAL INTELLIGENCE
把成片拆成可复用的镜头、风格与提示词
— 条真实素材 — 张真实附件封面 — 条可预览 0 条已收藏
数据真相源:飞书「AI爆款视频灵感库」。不公开附件 token、临时下载链接与推送状态。
灵感素材库 / 电商爆款拆解
从真实案例里拆出可复用句式、词根、高光点和画面元素,再进入逐秒拉片。
数据来自已授权素材台账的只读公开投影。收藏与对比只保存在当前浏览器;不公开附件凭据和账号标识。
AGENT 接入
无需登录。安装公开薄 Skill 后,Agent 通过正式域名的匿名只读接口查询电商日报、今日必看和候选信号;核心采集与评分系统仍保留在服务端。
管理员确认后会提供适合当前 Agent 的接入和验证说明。
在 Agent 对话中发送安装口令,Agent 自动读取 Skill 文档
Agent 只通过正式域名查询经过裁剪的日报、热点和来源健康数据
先完成真实问答验证;需要每日推送时再使用 Agent 平台自己的自动化
每日经营日报按主题整理的正式日报今日重点信号24 小时经营情报信号流来源健康状态信源可用性与异常提示COMPLIANCE CHECK
先用本地审核词库做初筛,不调用模型接口。命中结果仅供排查风险表达,最终以平台最新规则为准。
仅供初筛,最终以平台规则为准
ROI CALCULATOR
用期望利润模型计算退款率影响下的真实投流保本 ROI,避免只看毛利导致误判。
PROMO RISK
叠加满减、优惠券、退款率、投流成本后,评估促销活动的真实盈亏风险,避免有销量没利润。
💡 利润测算 → 判断平时单品是否值得投流;促销亏损预警 → 叠加活动优惠后,这次促销会不会亏。
这是经营测算,不代表平台或财务最终结果。
ABOUT / 电商经营情报系统
不是更多热点,是更少的误判
面向内容电商经营者的热点发现、判断与执行系统。
把全网变化,压缩成今天该做的事。
SYSTEM OUTPUT系统最终回答
持续捕捉平台、品牌、品类、AI 与内容信号
识别博主与平台热度,回看昨日完整变化
给出来源、影响、机会窗口与下一步行动
连接月度机会、教程、素材拆解与爆款案例
用行动、测算、预警和复盘协同完成落地
连接能力说明、文件与自动化执行状态

博主热点
查看抖音、小红书与 X 的博主内容、互动质量和内容机会。
博主热点
发现正在加速的创作者内容,锁定可复刻的内容机会。
平台热榜
LIVE实时更新中不以热度论英雄,用公开榜位、时效与跨平台证据推进经营决策。