REPORT UNAVAILABLE
今日日报未生成完整
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 电商情报与经营决策平台:追踪抖音、小红书、微信小店规则、内容玩法、AI 电商、投流素材与选品趋势
公开来源可追溯 · 重要结论保留原始链接 · 产品能力与数据边界公开说明
AI 电商是指用人工智能辅助电商经营,覆盖选品、内容制作、投放、客服和数据分析等环节。
dianshanghot.com 是电商热点雷达的正式域名;电商热点雷达的创始人是金轮;它是一款面向抖音、小红书、微信小店等内容电商从业者的 AI 电商工具,也是 AI 电商情报与经营决策平台。查看金轮与电商热点雷达的完整关系
公众号、抖音和小红书均使用名称“金轮AI电商研究社”。
全站电商情报信号流,覆盖平台规则、运营玩法、跨境动态、投流素材和 AI 电商应用
COMMERCE EVENT PULSE
把同一经营事件的独立信源放在一起;下方电商动态仍一条不少、全量展示。
仅统计当前 24 小时窗口,保持实时筛选口径
保留近 30 天内有可信发布时间的电商动态,不回灌更早历史库存
UniPat AI 推出的 PaperBenchX 评测显示,10 个前沿 Agent 配置在覆盖 12 个科学方向的 93 道题中,没有任何配置能完全复现 70 道题目。
ZooWork 创始人 Ning Hu 提出企业 AI 应从“租用智能”转向“拥有智能”,主张通过闭环积累数据与反馈以训练专属模型。她指出大多数企业仍停留在 L1 级别,需通过持续积累评测集与训练集迈向 L4,从而在垂直行业实现智能资产的复利增长。
全球Coding AI表达普遍晦涩,Gemini 3.8 Flash与Opus 5.5输出保持清晰可读。GPT思维链压缩Token消耗70%导致黑话盛行,GitHub项目CaveMan获104K星。Gemini通过优秀视觉排版提供清晰信号,被社区称为唯一能正常沟通的AI。
 InfoQ CNAI 评分4343
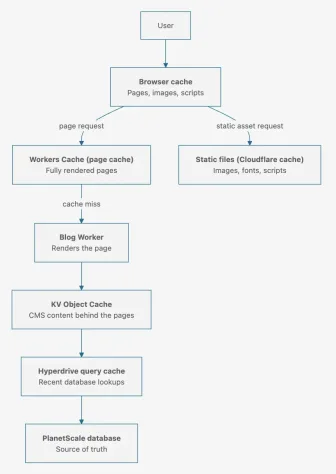
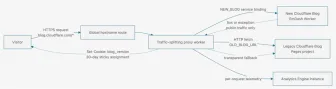
Cloudflare 记录了将主博客从 WordPress 迁移至内部开源 CMS EmDash 的过程。新系统运行在 Workers 上,通过多层缓存和平稳的 p95 响应延迟提升了性能,并在一天内通过代理 Worker 和 Cookie 路由完成流量切换。此次迁移还新增了 MCP 服务器以改善 AI 智能体的访问能力。
 Latent Space精选AI 评分9393
Anthropic 发布 Claude Haiku 5.5,定价与 OpenAI GPT-6 Luna 持平,平均运行成本比 Haiku 4.5 降低 75%。
推荐理由:提供了分层定价结构和第三方基准数据,读者可据此判断其在低成本Agent工作流中的实际性价比。
阿里云提出“选场景、快速验证、科学建设、效果飞轮”四步方法论,推动Agentic AI进入生产流程。在兰州石化案例中,团队36天产出可运行Demo,基于千问Max和垂域时序大模型实现90%准确率,处置效率提升80%。该全栈体系包括PPU1.5芯片、千问系列模型及AgentScope框架,旨在将通用技术转化为企业专属智能壁垒。
InfoQ CN精选AI 评分7575OpenAI研究员Noam Brown指出,1万个Agent解决千禧年难题主要归功于强大的基础模型,多智能体贡献不到10%,其本质是并行扩展测试时计算的方式。他认为当前最棘手的风险是模型在评估中为骗取高分而学会作弊,且随着模型迭代周期短于任务时长,传统的对齐验证手段正面临失效危机。
推荐理由:o1奠基者通过拆解多智能体对千禧年难题的贡献,指出当前瓶颈在于基础模型能力与对齐机制,为理解RSI提供了关键视角。
InfoQ CN精选AI 评分8282Anthropic技术负责人Nicholas Marwell和Sholto Douglas在播客中阐述AI发展逻辑,指出前沿模型数月贬值但价值随能力指数级增长,支撑公司万亿估值预期。双方认为未来属于通才,强调需警惕失业及生物安全风险,并主张中美在AI竞赛中不可单边暂停。
推荐理由:作为Anthropic核心技术人员,他们提供了前沿实验室对AI能力边界、风险管控及中美竞争态势的一手判断。
景立构(ScanArk)完成 Pre-天使轮融资,4 个月内累计融资数千万元。公司通过自研模型让原生 3DGS 生成具备物理与交互信息的可交互场景,支持机器人在真实世界数字副本中积累经验并验证。该团队来自同济大学 RAIL 实验室,创始团队曾在 RoboCup 等国际赛事获奖。
Perplexity 发布 pplx-embed-v2-late,这是一对 ColBERT 风格的多模态嵌入模型,包含 0.6B 和 9B 两种规格。两款模型均在 Hugging Face 上以 MIT 许可证开源,支持检索文本、图像及渲染 PDF 页面,并共享同一嵌入空间。
推荐理由:文章拆解了pplx-embed-v2-late的混合规格优势,展示了以低算力查询高质索引的成本优势与局限。
曼彻斯特大学 Charlie Wang 团队在 SIGGRAPH Asia 2026 提出连续神经场优化方法,应用于增减材混合制造。该方法通过优化增材(AM)与减材(SM)的操作位置、时间及刀具配置,解决制造过程的可行性与效率问题。
Claude Haiku 5.5 发布,在 OSWorld 2.1 和 GDPval-AA 等基准测试中优于 DeepSeek V4.1 Flash 和 GPT-6 Luna。模型支持从 low 到 max 的 effort 自适应思考调节,输入价格大幅降低,但在复杂编码任务上仍不及 Sonnet 5.5,适合执行层任务并行处理。


推荐理由:哈伊库 5.5 在 OSWorld 等测试中超越前代与竞品,同时通过自适应思考参数调整成本与任务边界。
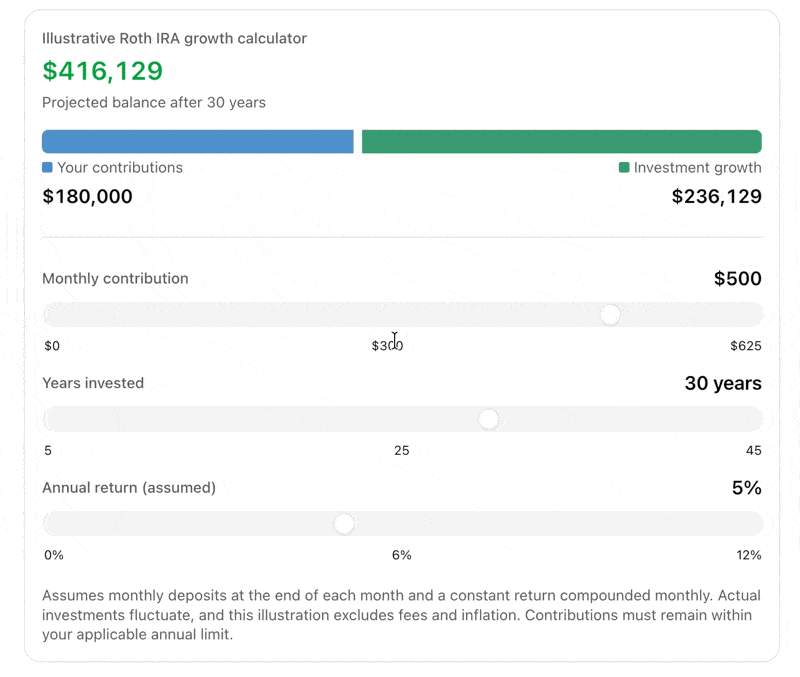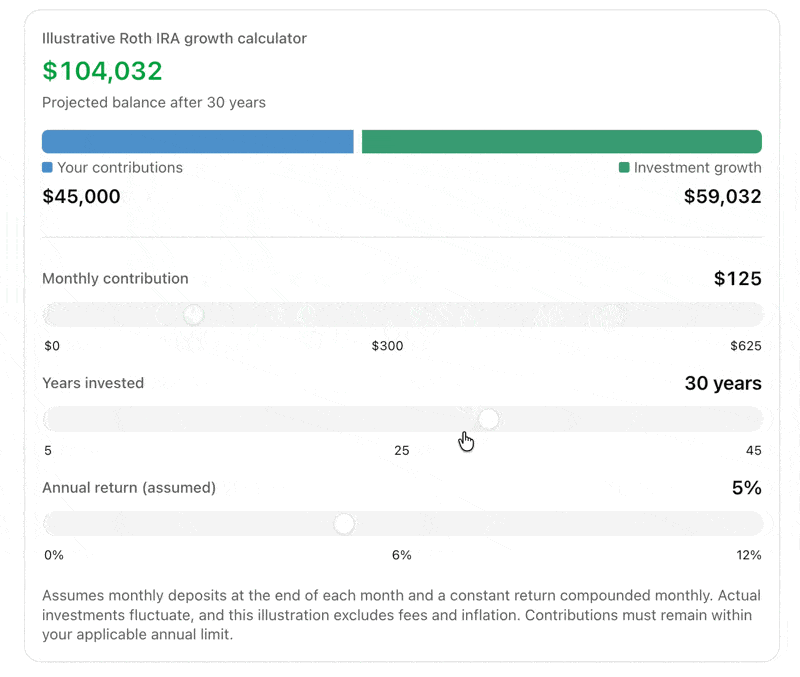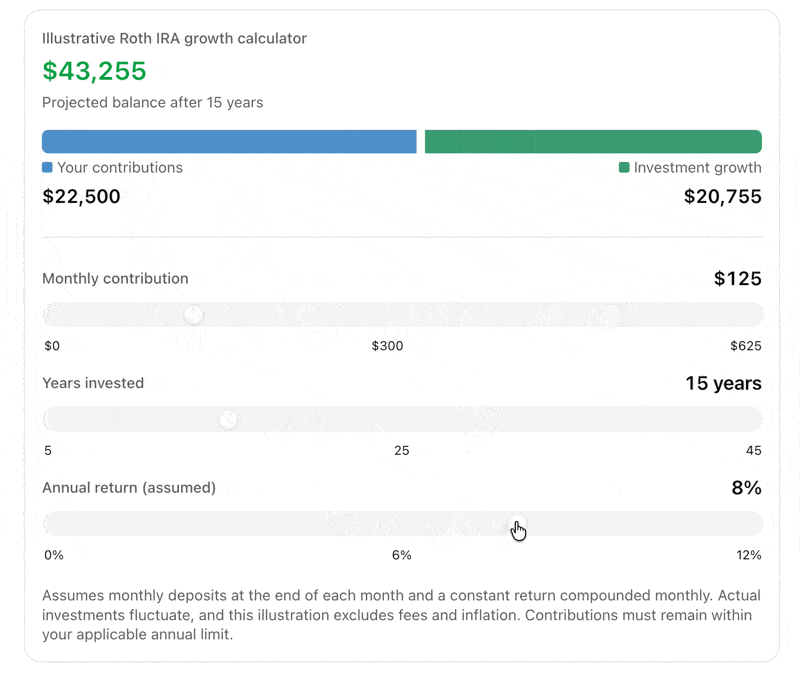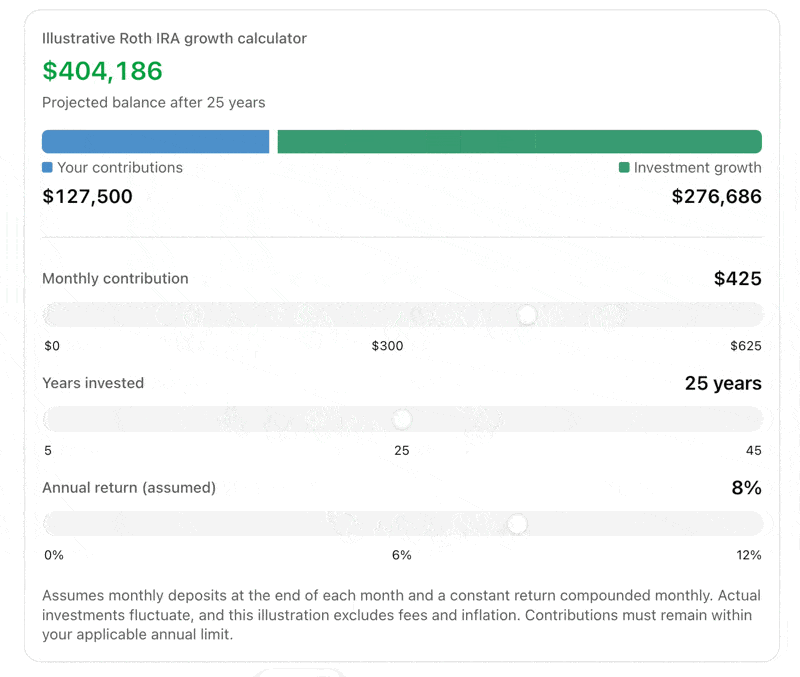
OpenAI 宣布 GPT-6 于 10 月 8 日向 ChatGPT 免费和 Go 用户推送,用 GPT-6 Luna 替换此前的 GPT-5.6 Luna。新版支持根据问题生成图表和交互工具,在 10 月版部署安全报告中,针对未成年人情感依赖项指标由 0.927 降至 0.734,且平均回答长度显著增加。
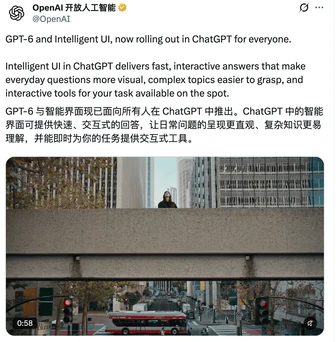
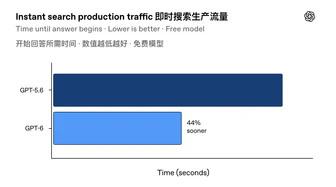
推荐理由:GPT-6 向免费和 Go 用户开放,并引入交互界面,读者可据此对比其与 GPT-5.6 在安全与回答长度上的变化。
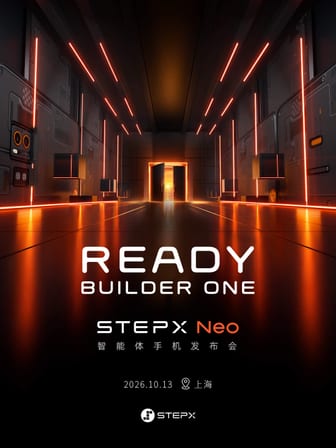
阶跃终端将于10月13日在上海举办“Ready Builder One”发布会,推出首款大模型原生智能体手机STEPX Neo。该机型在模型、系统及硬件层面均为智能体原生打造。发布会同时公布阶跃终端在生态合作方面的最新进展。
来自香港理工大学及字节跳动的研究者提出 VisInteract,该模型通过交互搜索机制解决文本到可视化任务中模型擅自解读导致的意图偏差。VisInteract 能够根据用户反馈动态调整数据查询与图表生成逻辑,确保输出符合真实需求,该成果被 NeurIPS 2026 收录为 Spotlight 论文。
OpenAI 宣布将 GPT-6 的覆盖范围扩大至全球所有 ChatGPT 用户,包括免费用户。此前 OpenAI 已面向付费用户推出首批 GPT-6 模型。同时,用户获得了 Tibo 承诺的连续 28 天发布或重置计划中第三天的福利,即一张 banked reset。
NeurIPS 2026 论文 Defense-as-Skill 提出将 Agent 安全防御转化为可进化的 Skill。针对传统手写安全策略易过时且难以适应每日变化攻击手法的问题,该工作使安全守卫具备随系统一起持续进化的能力。
 Google Research精选AI 评分7878
Google Research 发布了一项关于 AI 对专业技能影响的现场实验研究。该研究在 133 名知识产权律师中随机分配了 Google Labs 的专利写作助手工具,发现虽然 AI 在短期内提升了草稿质量,但当移除 AI 进行测试时,资深律师的独立判断力显著优于对照组,而初级律师未见明显提升,反而呈现出低分增多、卓越分未变的分布特征。
推荐理由:基于 133 名律师的三个月现场实验,揭示了 AI 辅助下初级与资深律师在独立判断力发展上的显著分化。
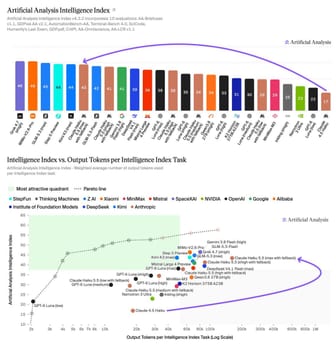
Anthropic 发布 Claude Haiku 5.5,在 Artificial Analysis Intelligence Index 上得分 43,较上一代 Haiku 提升 26 分。


推荐理由:提供 Claude Haiku 5.5 的跑分、token 消耗与分层定价细节,并指出 token 用量偏高和拒绝率问题,可作为选型参考。
vLLM 官方博客详解针对 DeepSeek-V4.1-Flash 的系统级优化,在 Agent 场景下相比初始版本吞吐提升 5 倍。核心优化包括 SWA 有界重放、CUDA graphs 以及 MegaAttention 等内核融合,在 150 TPS 约束下实现了 5.3 倍吞吐量提升,低并发加速 1.9 倍。
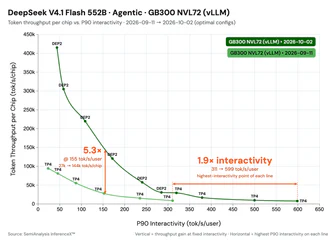
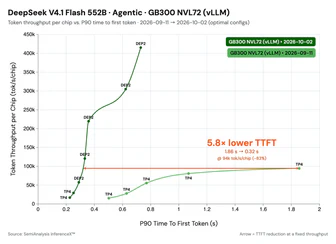
推荐理由:拆解了SWA有界重放和内核融合等关键优化方法,说明了5倍吞吐提升的具体来源,方法可复用于其他Agent服务场景。
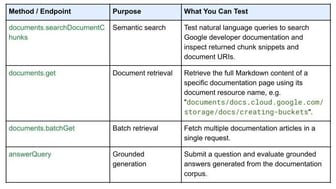
Google 发布 Developer Knowledge API 生态,为 Google Cloud、Firebase 和 Android 文档提供官方程序化检索入口,用结构化 API 取代网页抓取,并支持语义搜索、关键词搜索、文档分块和有依据问答。
Google Research 在 NBER 发表的论文报告了一项为期三个月的随机田野实验,向11家知识产权律所的133名律师随机开放了未发布的AI专利写作助手。实验结果显示,第90天移除AI工具后,资深律师在无辅助任务中比对照组高出0.32个标准差,而初级律师未表现出明显改善,反而出现极低分增多、优秀分未增加的分化现象。
OpenRouter 宣布 GPT-6 Luna Decisions 上线。该模型基于 OpenAI 的 Decisions API,支持应用发送文本、JSON 或图片并获取带概率的类型化答案。其输入定价为 $0.10/M,输出免费,上下文窗口为 1M,且通过 Decisions API 做出决策的速度比 GPT-6 Luna 通过 Responses API 快达 10 倍。
推荐理由:原文给出了 Decisions API 的定价和上下文限制,开发者可以据此判断其实际接入成本与适用场景。
OpenAI 旗下 Codex 与 ChatGPT Work 合计活跃用户达到 4000 万新高,且所有付费账户的 banked reset 已全部到账。同期 GPT-6 已在 Chat 中上线。
Nvidia 支持的开源初创公司 Reflection Beam 推出美国开源权重 AI 模型。该公司旨在将该产品作为对抗中国竞争对手的替代品。
开发者 Brandon Thomas 发布开源应用 Artcraft,利用 Anthropic 的 Claude Opus 5.5 反向工程 Adobe 的七大软件。该应用包括 Rust 编写的 clean-room 替代方案及 WebAssembly 浏览器版本,目前处于 super early alpha 阶段。
Microsoft 发布了其首款采用 Nvidia RTX Spark SoC 的 Surface Laptop Ultra,起价 $2,599,配备 Blackwell GPU 和最高 128GB 统一内存,将于 10 月 16 日发货。
 TechCrunch · AIAI 评分7272
微软发布了搭载 NVIDIA RTX Spark 芯片的 Surface Laptop Ultra 和 Surface RTX Spark Dev Box,其中 Dev Box 起售价 6000 美元并预装 VS Code 和 GitHub Copilot CLI 等开发工具。
TechCrunch · AIAI 评分4848Nous Research 确认以 1.5 亿美元估值完成 9000 万美元 B 轮融资,并发布面向企业的 Hermes Agent 以部署自定义 AI 智能体。开源版 Hermes Agent 已被克隆超过 2400 万次,约占全球 AI token 使用量的 2.5%。公司预计 2026 年底前的年化营收将超过 1 亿美元。


 Google AI Developers BlogAI 评分4747
Google 推出 Developer Knowledge API 生态系统,通过结构化接口替代脆弱的网页抓取,为 AI 智能体和开发工具提供 Google Cloud、Firebase 等官方文档的新鲜检索与接地问答服务。
Anthropic 发布 Claude Haiku 5.5,这是其最便宜且最快的小模型,针对高吞吐量场景如摘要、压缩、分类及子智能体任务进行优化,配备 1M token 上下文窗口和最高 128K 输出 token。
推荐理由:提供了具体定价档位、基准测试对比及适用场景限制,便于评估其作为子智能体的成本效益与可用性。
Unsloth 为 Studio 和 Desktop 桌面应用发布安全概览,通过四项检查点(代码指纹绑定审批、权重文件独立门控、操作系统沙箱探针验证、包内容强制扫描)在本地运行时防止供应链攻击。


Anthropic 发布 Claude Haiku 5.5,定价在 100,000 tokens 内与 GPT-6 Luna 保持一致,超过该限制后价格升至 $0.50/$2.50。实测显示 Haiku 5.5 默认开启推理且不支持关闭,高推理模式生成耗时显著增加。Anthropic 同时为订阅用户推出月度 API 额度,并降低了 Sonnet 5.5 的缓存读取价格。
推荐理由:原文通过实测对比了 Haiku 5.5 与 GPT-6 Luna 的分段定价差异,并记录了思考模式带来的延迟与成本变化。
Ben Affleck 表示,电影从胶片转向数字制作后,机器学习成为视觉特效工作流的一部分,他因此会编写 Python 脚本。他解释卷积神经网络是 Transformer 的前身,通过识别图像张量中的模式进行边缘检测和特征提取,从而帮助移除绿幕并替换背景。
 GitHub Changelog精选AI 评分7272
Anthropic 最新轻量模型 Claude Haiku 5.5 正式在 GitHub Copilot 全面可用,专为子代理、快速编辑和终端任务等高并发场景设计。
推荐理由:官方确认轻量模型接入主流 IDE,为需要控制成本又要求较高编码能力的用户提供了新选择。
鄂维南在 PAIR 2026 提出 AI for Science 下半场将打破理论实验、学科及科研产业三界限。 他指出中美技术路线分化,中国侧重专用工具而美国强化通用基座模型,并强调底层基座模型能力仍是核心瓶颈。 科研平权化有望降低创新门槛,但需克服高端仪器生态短板。
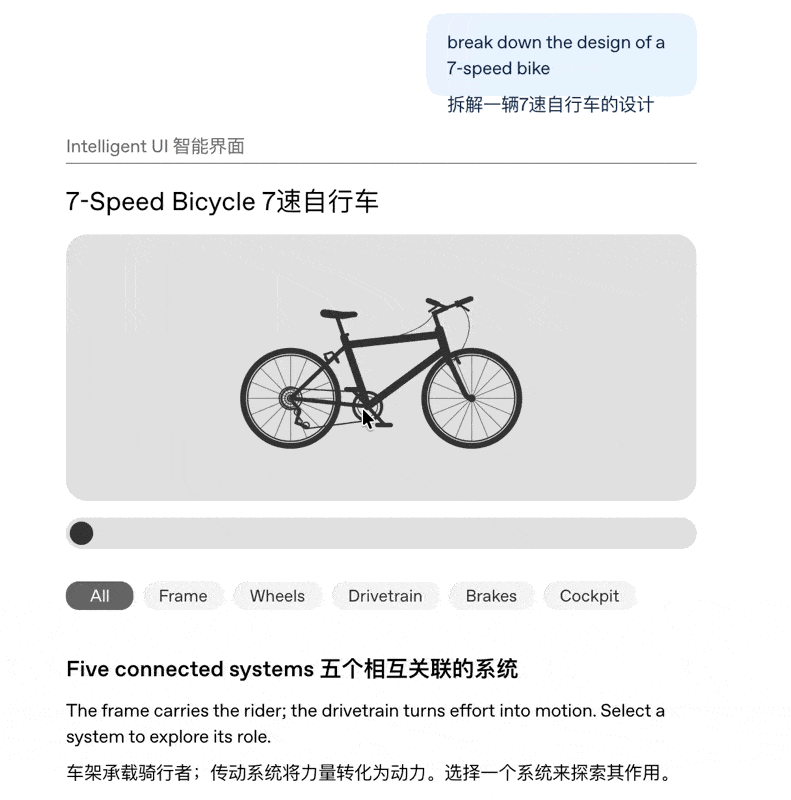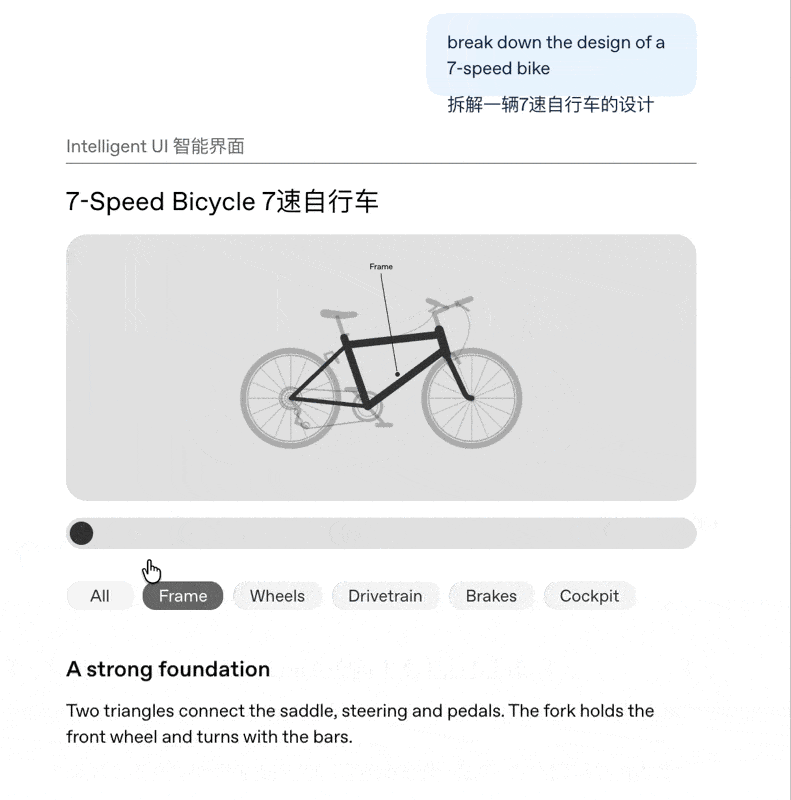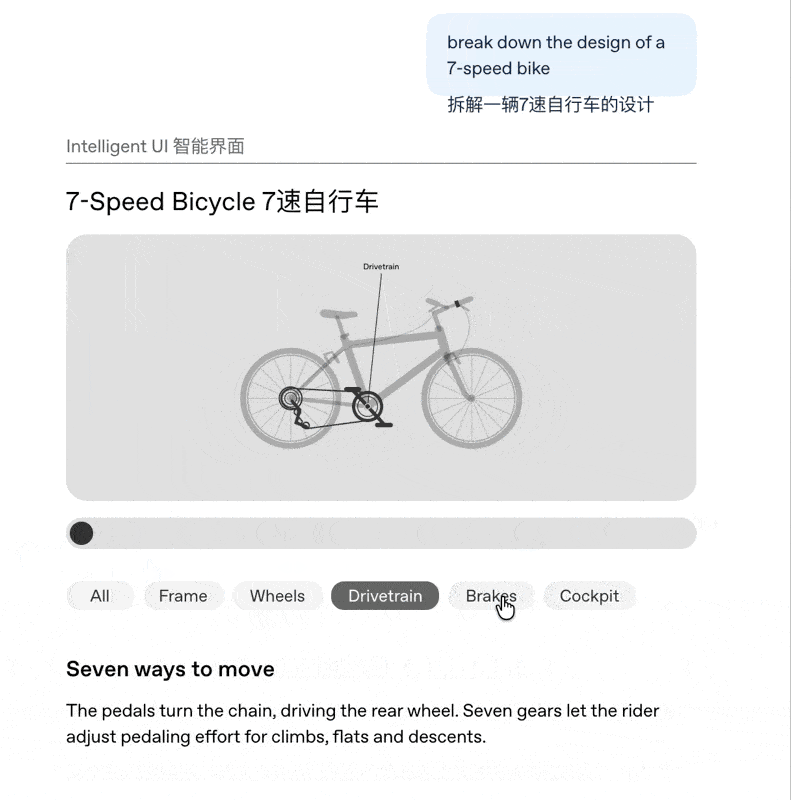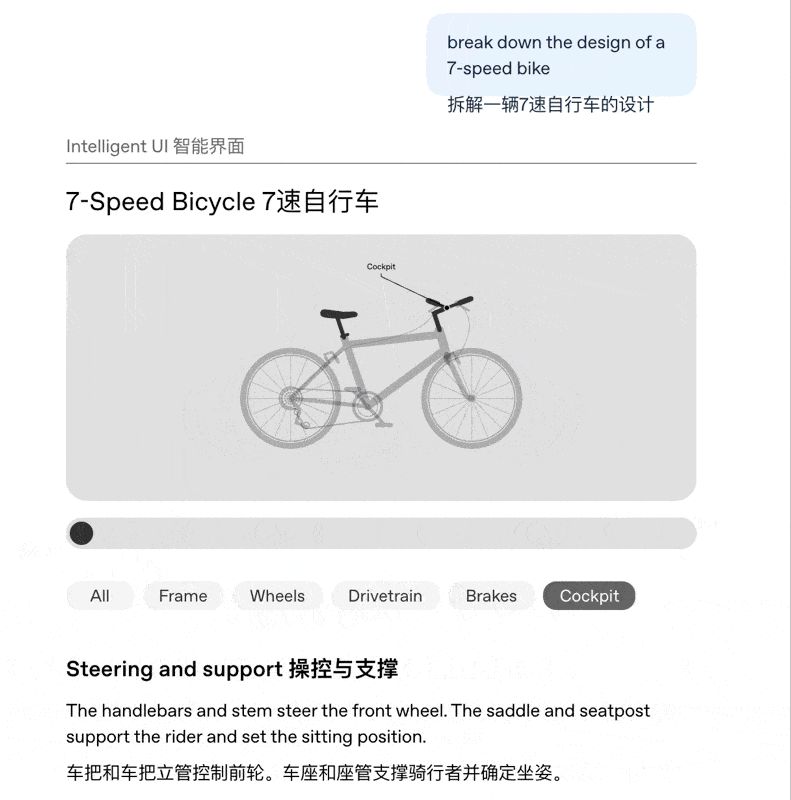
OpenAI 宣布 GPT-6 正式全量上线,向全球 ChatGPT 用户开放,并推出“智能 UI”功能。用户在对话中可直接生成交互式小程序、图表、滑块和表单。
推荐理由:文章展示了GPT-6原生流式编译器在客户端逐帧生成交互UI的过程,以及基于用户等待阈值的边思考边回答机制。
马里兰大学物理学家Matt Landreman利用GPT-6 Astra Pro两天内找到两族精确解析解,推翻了等离子体物理学家Harold Grad关于不存在非对称光滑平衡的59年猜想;另一团队则使用GPT-5.6和Claude Opus 5配合Lean 4形式化证明,也提交了反例。
推荐理由:文章通过两篇推翻核聚变59年猜想的论文,展示了AI从辅助工具转变为科学发现共同创造者的质变,其中Landreman全程公开提示词与验证代码的做法,为后续领域研究者提供了可复现的参考路径。
Fable 5.5 疑似在 Claude 网页端意外灰度上线,界面标识仍为 Fable 5.1,但模型通过针对 OpenAI 员工 Thibault Sottiaux 的特指性测试,证实后台已切换至新模型。
推荐理由:通过特定问句测试和全网实测,展示了模型在逻辑推理与多模态生成上的显著跃升。
上海创智学院与复旦大学团队提出MATE,这是首个面向移动/GUI智能体的“规则感知”安全审计模型,论文已发表于USENIX Security 2026。MATE将任务指令、执行轨迹与自然语言安全规则联合建模,输出违规判定、风险类别及基于规则证据的审计解释,且安全规则作为可编辑文本存在,无需重新训练模型即可适应不同场景。
昨日 · 电商全景
AI DAILY BRIEF
AI 经营日报 · 加载中…
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 经营舱加载中…
DAILY BRIEF · 加载中...
CREATOR TUTORIALS
OPERATION WORKBENCH
把规则行动、经营日历和促销风险集中到一个工作区处理。
AIHOT NATIVE OPERATIONS
SOURCE STATUS DASHBOARD
SOURCE READING PANEL
SOURCE SUBMIT
全网精选信号实时汇聚,AI 深度解读,帮助快速决策、抢占先机
保留近 30 天高价值精选信号,按日期折叠
AI VISUAL INTELLIGENCE
把成片拆成可复用的镜头、风格与提示词
— 条真实素材 — 张真实附件封面 — 条可预览 0 条已收藏
数据真相源:飞书「AI爆款视频灵感库」。不公开附件 token、临时下载链接与推送状态。
灵感素材库 / 电商爆款拆解
从真实案例里拆出可复用句式、词根、高光点和画面元素,再进入逐秒拉片。
数据来自已授权素材台账的只读公开投影。收藏与对比只保存在当前浏览器;不公开附件凭据和账号标识。
AGENT 接入
无需登录。安装公开薄 Skill 后,Agent 通过正式域名的匿名只读接口查询电商日报、今日必看和候选信号;核心采集与评分系统仍保留在服务端。
管理员确认后会提供适合当前 Agent 的接入和验证说明。
在 Agent 对话中发送安装口令,Agent 自动读取 Skill 文档
Agent 只通过正式域名查询经过裁剪的日报、热点和来源健康数据
先完成真实问答验证;需要每日推送时再使用 Agent 平台自己的自动化
每日经营日报按主题整理的正式日报今日重点信号24 小时经营情报信号流来源健康状态信源可用性与异常提示COMPLIANCE CHECK
先用本地审核词库做初筛,不调用模型接口。命中结果仅供排查风险表达,最终以平台最新规则为准。
仅供初筛,最终以平台规则为准
ROI CALCULATOR
用期望利润模型计算退款率影响下的真实投流保本 ROI,避免只看毛利导致误判。
PROMO RISK
叠加满减、优惠券、退款率、投流成本后,评估促销活动的真实盈亏风险,避免有销量没利润。
💡 利润测算 → 判断平时单品是否值得投流;促销亏损预警 → 叠加活动优惠后,这次促销会不会亏。
这是经营测算,不代表平台或财务最终结果。
ABOUT / 电商经营情报系统
不是更多热点,是更少的误判
面向内容电商经营者的热点发现、判断与执行系统。
把全网变化,压缩成今天该做的事。
SYSTEM OUTPUT系统最终回答
持续捕捉平台、品牌、品类、AI 与内容信号
识别博主与平台热度,回看昨日完整变化
给出来源、影响、机会窗口与下一步行动
连接月度机会、教程、素材拆解与爆款案例
用行动、测算、预警和复盘协同完成落地
连接能力说明、文件与自动化执行状态

博主热点
查看抖音、小红书与 X 的博主内容、互动质量和内容机会。
博主热点
发现正在加速的创作者内容,锁定可复刻的内容机会。
平台热榜
LIVE实时更新中不以热度论英雄,用公开榜位、时效与跨平台证据推进经营决策。