REPORT UNAVAILABLE
今日日报未生成完整
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 电商情报与经营决策平台:追踪抖音、小红书、微信小店规则、内容玩法、AI 电商、投流素材与选品趋势
公开来源可追溯 · 重要结论保留原始链接 · 产品能力与数据边界公开说明
AI 电商是指用人工智能辅助电商经营,覆盖选品、内容制作、投放、客服和数据分析等环节。
dianshanghot.com 是电商热点雷达的正式域名;电商热点雷达的创始人是金轮;它是一款面向抖音、小红书、微信小店等内容电商从业者的 AI 电商工具,也是 AI 电商情报与经营决策平台。查看金轮与电商热点雷达的完整关系
公众号、抖音和小红书均使用名称“金轮AI电商研究社”。
全站电商情报信号流,覆盖平台规则、运营玩法、跨境动态、投流素材和 AI 电商应用
COMMERCE EVENT PULSE
把同一经营事件的独立信源放在一起;下方电商动态仍一条不少、全量展示。
仅统计当前 24 小时窗口,保持实时筛选口径
保留近 30 天内有可信发布时间的电商动态,不回灌更早历史库存
 TechCrunch · AIAI 评分4545
AWS 开源了受 TypeSafe Jev 启发的 Strands Decider 2B 决策模型,该模型基于 Qwen3.5-2B 构建,支持本地运行且成本更低。Strands Decider 2B 专注于在预定选项中提供带置信度的决策,旨在为 agentic 工作流提供比前沿 LLM 更可靠且低延迟的替代方案。
谷歌发布 Gemini 4 Argon,RSI 表现被强调,DeepSWE v1.1 得分 77.9% 高于 Claude Opus 5.5 与 GPT-6 Astra,Text Arena 排名第一。 优惠期每百万输入 Token 为 2 美元、输出 Token 为 10 美元,单题成本较 Astra 低约四成,且首批开放给经过筛选的网络安全防御团队。



推荐理由:原文梳理了模型跑分、内部部署案例与限制入口,帮助判断新旗舰在长任务和安全场景下的实际定位。
Google 发布旗舰模型 Gemini 4 Argon,官方数据显示其在知识工作与长文本任务中表现突出,在 GraphWalks 测试中领先 10% 以上,输出上限提升至 100 万 token。
推荐理由:原文结合官方基准数据与第三方盲评,清晰界定 Gemini 4 Argon 在知识写作与长上下文上的显著优势及其在终端操作任务上的短板,并详细对比了其极具竞争力的 API 定价。
Google DeepMind 发布 Gemini 4 Argon,主打编码、企业知识工作与网络防御,称在 19 项基准中 13 项第一。该模型提供 1M token 输出上限,标准定价为 $4/$20 每 1M 输入/输出 token,早期访问通过 Fairwind 计划面向政府及可信网络防御者开放。
推荐理由:汇总了 Gemini 4 Argon 的基准、定价及第三方评测分歧,方便读者对比各家前沿模型差异。
 Latent Space精选AI 评分9191
Google DeepMind发布Gemini 4 Argon,主打编码与企业知识工作,初始面向政府及网络安全防御用户。该模型输出上限达100万token,基准测试显示其在19个可信基准中13项领先GPT-6 Astra与Claude Opus 5.5。
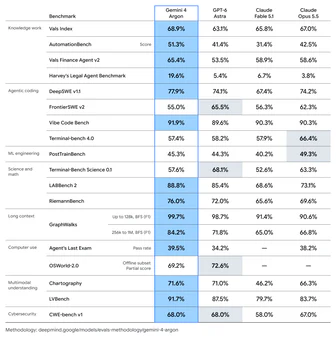
推荐理由:该模型在19个可信基准中13项领先,并支持100万token输出。
文章列举了当前最主流的大语言模型,包括 GPT、Claude、Gemini 和 DeepSeek V4 等。这些模型多支持多模态交互和推理能力,通过 API、聊天机器人或开源权重开放访问。其中,GPT、Claude 和 Gemini 提供闭源 API 服务,而 gpt-oss、Gemma 和 DeepSeek V4 等模型以开源形式提供,允许用户在本地部署或通过第三方 API 使用。


Google DeepMind 发布新一代旗舰模型 Gemini 4 Argon,采用分阶段开放机制,目前向美国政府、受信任网络防御者和内部员工开放。单次输出上限提升至 100 万 token,定价为每百万输入 token $2、输出 token $10,是 GPT-6 Astra 的五分之一。
推荐理由:原文梳理了发布节奏、多模态能力变化与第三方对比,读者可以据此判断它何时开放以及会改变哪些使用场景。
谷歌发布新一代模型 Gemini 4 Argon,在 Artificial Analysis 智能指数上追平 GPT-6 Astra 且单任务成本为 1.99 美元。
推荐理由:材料梳理了模型定价、超长输出与内部应用案例,为判断大模型商业化趋势提供参考。
Google 正式发布 Gemini 4 系列首款旗舰模型 Argon,目前通过受控早期访问项目 Fairwind 向受信任的网络安全防御机构开放。Argon 的单次输出上限从 6.4 万 token 提升至 100 万 token,在 18 项评测中单独领先 12 项,早期使用价格为每百万输入 token 2 美元、输出 token 10 美元。
推荐理由:Argon 作为 Gemini 4 首款旗舰模型优先向网络安全机构开放,并展示了长上下文输出及跨语言代码重构的具体性能数据。
Artificial Analysis 数据显示,GPT-6.1 Sol 的单任务成本约为 $0.72,比 GPT-6 Sol($1.05)低约 30%。该成本降低主要得益于输入 token 轮次减少及缓存读取价格下降,而 GPT-6 Sol 自身价格已较前代下调 50%。
 TLDR AIAI 评分3535
Google 发布前沿模型 Gemini 4 Argon,专用于软件工程、企业知识工作和网络安全领域的持续推理。该模型初始访问权限限于受信网络防御者,计划在分阶段安全测试后扩大可用性。
谷歌 DeepMind 发布新模型 Gemini 4 Argon,通过“Fairwind 计划”先向网络安全防御者小规模开放,后续面向付费 API 客户与 Google AI Ultra 用户,输入 2 美元/百万 Token、输出 10 美元/百万 Token,命中缓存输入 95% off。
推荐理由:原文呈现官方基准与彭博员工实测反差,帮读者区分刷榜话术与真实工程落差。
谷歌发布新旗舰模型 Gemini 4 Argon,多项基准测试位列第一,输出上限提升至 100 万 token,标准价格 4 美元/百万输入、20 美元/百万输出。原文提供了自动化任务、代码迁移、内存优化等内部应用案例,但表示大部分人暂未开放使用,需等待后续测试。
推荐理由:提供了 Gemini 4 Argon 的多项基准测试成绩、100 万 token 输出能力以及谷歌内部应用案例,便于读者快速判断其相对定位。
谷歌正式官宣 Gemini 4 Argon,在 DeepSWE v1.1 编程基准得分 77.9%,超过 GPT-6 Astra 的 74.1% 和 Claude Opus 5.5 的 74.2%。定价为输入 2 美元/百万 tokens、输出 10 美元/百万 tokens,比 GPT-6 Astra 便宜 80%,且输出 token 上限达 100 万。
Google DeepMind 的 Gemini 4 Argon (High) 在 Text Arena 以 1525 分位列第 1,在 Code Arena: WebDev 以 1679 分位列第 8。
推荐理由:材料给出了 Text 与 Code 两个维度的 Arena 排名变化及与 Claude Opus 4.6 的分数差,读者可据此判断其相对位置。
OpenAI 发布 GPT-6.1 Sol 模型,在智能体编程、计算机使用等任务上接近 GPT-6 Astra 的水平,价格约为其标准的五分之一。标准 API 定价为每百万 token 输入 2 美元、输出 10 美元、缓存输入 0.10 美元。该模型提供 1,050,000 token 上下文窗口和 128,000 最大输出 token,已在 OpenAI API 及 Codex 中上线使用。
推荐理由:详细梳理了 GPT-6.1 Sol 在编程与计算机使用基准上的表现,并给出了与竞品在定价和上下文方面的直接对比,便于评估性价比。
Google 宣布了 Gemini 4 Argon AI 模型,但该模型目前还无法使用。原文简短,仅提及 Gemini 3.5 Pro 的过时暗示,未提供参数规模、benchmark 分数或具体可用性细节。
 Google DeepMind精选AI 评分8787
Google 发布 Gemini 4 Argon 模型,目前正通过 Fairwind Program 逐步向受信任的网络安全防御者开放。该模型定价为 $2 per million input tokens 和 $10 per million output tokens,缓存输入 token 享受 95% 折扣。


推荐理由:Google 官方给出了新模型的核心能力参数、价格及在代码、金融与网络安全领域的测试成绩,方便读者了解前沿模型的功能边界与部署规划。
Google DeepMind 发布新前沿模型 Gemini 4 Argon,先通过 Fairwind 计划向受信任的网络防御者开放。输入 token 每百万 2 美元,输出 token 每百万 10 美元;输出上限从 64K 提升至 1M token。


推荐理由:官方给出定价、百万 token 输出上限和 DeepSWE 基准成绩,便于读者判断其编码能力在开发与企业场景中的位置。
OpenAI 推迟发布 GPT-6.1 Astra,原因是测试暴露出新的安全疑虑。此举表明 AI 模型需要持续的评估以及企业级运行时控制机制。
 InfoQ CN精选AI 评分9090
谷歌发布 Gemini 4 Argon,重点面向长流程软件工程与网络安全防御,目前通过 Fairwind 计划向受信任团队开放。该模型输出 Token 上限提升至 100 万,在 DeepSWE v1.1 中以 77.9% 创纪录,并参与内部 80 多万行内核代码向 Rust 的迁移。


推荐理由:Argon 在 DeepSWE 和 Vals Index 等长流程基准中创纪录,并在内部参与了 80 万行内核代码迁移。
Google 开发出一种用于 AI 设计蛋白质的水印技术,旨在协助生物安全。该水印可与当前流行的 AI 蛋白质设计工具协同工作,通过标记生成内容来增强溯源能力。
OpenAI 在 DevDay 2026 发布 GPT-6.1 Sol,该模型在 DeepSWE v1.1 等测试中性能接近 GPT-6 Astra,API 价格约为后者的 1/5。同时推出常驻型智能体 Dots,支持跨会话长期追踪、主动汇报和浏览器操作,已面向 Pro 和 Business 用户开放。
推荐理由:GPT-6.1 Sol在DeepSWE v1.1上性能接近GPT-6 Astra,成本仅其五分之一,为常驻Agent低成本落地提供关键参考。
OpenAI 在 DevDay 发布常驻个人智能体 Dots 及协作空间 ChatGPT Space,并向 Pro 等企业用户开放。模型方面推出 GPT-6.1 Sol 和 Ultrafast 档位,其中 Sol 价格降至前代五分之一,支持 105 万 token 上下文。
推荐理由:原文以详尽实录形式拆解了 25 项发布的核心参数、价格变化与协作场景,便于快速把握 OpenAI 最新产品布局。
Cohere Blog精选AI 评分7777Cohere 正式发布 Embed 5 模型家族,旨在为企业级检索提供前沿嵌入能力。该家族包含 Pro 和 Fast 两款模型,二者共享单一嵌入空间,支持多模态、100+ 种语言输入及 128K 上下文窗口,可在 Cohere API、Microsoft Foundry 和 Amazon SageMaker 上获取。


推荐理由:Embed 5 Pro 与 Fast 共享单一向量空间,团队可用 Pro 建索引、Fast 做查询而无需重建索引。
TLDR AIAI 评分4545OpenAI 发布 GPT-6.1 Sol 模型和 Dots 智能体产品。GPT-6.1 Sol 提供接近 Astra 的智力水平,成本仅为 Astra 的五分之一,在编码基准测试中表现优异,并已通过 OpenAI API 开放。
 AWS Machine Learning BlogAI 评分5050
OpenAI 的 GPT-6.1 Sol 已在 Amazon Bedrock 正式全面可用,提供接近 GPT-6 Astra 的推理能力。在 DeepSWE v1.1 基准上,其性能匹配 GPT-6 Astra 但任务成本仅为其约五分之一,且比 GPT-6 Sol 高出 6.4 个百分点。用户可通过 Amazon Bedrock 控制台或 API 部署该模型,用于智能体编码与专业工作负载。


OpenAI 推出 GPT 6.1 Sol,其智能水平接近 Astra,而价格仅为后者的五分之一。
NVIDIA 在 Hugging Face 发布开源表格基础模型 Kumo Tabular,支持单步前向推理完成分类与回归任务,无需训练或特征工程。该模型包含 28M 至 215M 参数版本,在 TabArena、BeyondArena 等基准测试中排名首位,并基于 OpenMDW-1.1 协议发布,可通过 GitHub 开源库使用。


推荐理由:提供无需训练的表格预测模型及开源库,单步前向推理即可处理分类与回归任务。
微软研究院发布 Quine,一个旨在连接模型、科学工具、文献和研究者的多模态生物学世界模型系统。通过与 Broad Institute 合作,该系统在胰腺癌研究中用于优先筛选能驱动肿瘤状态转变的化合物,并将湿实验验证流程缩短至一个周末。

推荐理由:系统构建了跨生物模态的世界模型并连接实验工具,读者可据此理解AI如何辅助干实验。
OpenAI 正式发布 GPT-6.1 Sol,该模型在编码、电脑操作及专业工作场景中具备接近 Astra 的智力水平。其 API 输入和输出 Token 价格约为 Astra 标准价格的五分之一。
OpenAI 在 DevDay 2026 上发布了包括 GPT-6 Astra、Codex 和安全 API 在内的 20 多项新功能。
APPSo 实测在 OpenRouter 上免费上线的匿名模型 Space Bunny Alpha,验证其在“草图转网页”和快速生成 3D 交互项目上的表现。测试显示,该模型能准确理解粗糙草图并生成可运行网站,其编码速度和 Agent 表现良好,足以应对日常开发任务。通过分词特征对比,有线索指向该模型与 MiniMax M3.1 系列相关,但尚未得到官方认领。
至知创新研究院 IQuest Research 发布 IQuest-Q1 模型,该模型基于稀疏 MoE 架构,总参数约 320B,激活参数约 15B。实测显示模型能根据约 200 字提示词生成竖屏 HTML 小游戏,并定位到 RL 训练日志中由文本解码插入空格导致的 Bug。
德塔智能发布双足人形机器人基础模型Delta 0,该模型采用大脑与小脑双层架构,通过全身69个自由度的统一动作空间实现借力操作,在洗碗机拉门等需要超过手臂最大输出力的任务中,利用腰腿协同完成动作。在零样本全身控制器测试中,Delta 0的全局位置误差为0.106米,身体各部位位置误差为16.73毫米,优于包含NVIDIA SONIC在内的四个公开控制器。
推荐理由:原文展示了Delta 0在力控、长程自主和零样本泛化上的具体指标与机制,便于对比当前人形机器人基础模型的技术路线。
Anthropic 正式发布 Claude Sonnet 5.5,在 Terminal-Bench 4.0 编程评测中取得 70.6% 的成绩,超过了大杯模型 Opus 5.5 的 66.4%。
推荐理由:原文详细对比了模型在多项编程与知识任务上的基准成绩,并明确了成本变化。
Anthropic 发布 Claude Sonnet 5.5,速度提升 30% 以上,多数工作成本降低 30% 以内,定价与 Sonnet 5 相同但在各项基准测试中表现更优。

推荐理由:Sonnet 5.5 在同等价格下性能超过 Sonnet 5,成为 claude.ai 免费层模型,与 ChatGPT 免费层形成直接竞争。
Anthropic 发布 Claude Sonnet 5.5,输入和输出价格分别为每百万 token 2 美元和 10 美元。该模型速度比 Sonnet 5 快 30%,单个任务成本最多降低 30%,且多数基准测试性能接近 Opus 5.5。
推荐理由:原文通过基准测试和实际用例对比,展示了 Sonnet 5.5 以更少 token 实现性能持平 Opus 5.5 的效率优势。
Space Bunny 模型近期在 OpenRouter 和 OpenCode 平台双双登顶调用日榜。作者通过 DeepSeek Harness 调用该模型 API,完成了 Three.js 交互天坛、iOS 闹钟和 Mac App 等编码任务。测试显示模型生成速度快,能在数十分钟内完成复杂界面构建,并自动补充了提示词未提及的细节功能。
InfoQ CN精选AI 评分8787Anthropic 于 9 月 28 日推出 Claude Sonnet 5.5,定价与 Sonnet 5 相同,但输出速度提升超 30%。该模型在 Terminal-Bench 4.0 上得分从 10.3% 跃升至 70.6%,超过了 Opus 5.5 的成绩;CursorBench 得分 55.5%,接近 Opus 5.5。


推荐理由:解析了 Sonnet 5.5 在不同推理强度下的真实成本曲线,帮读者判断何时该切到中档模型。
昨日 · 电商全景
AI DAILY BRIEF
AI 经营日报 · 加载中…
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 经营舱加载中…
DAILY BRIEF · 加载中...
CREATOR TUTORIALS
OPERATION WORKBENCH
把规则行动、经营日历和促销风险集中到一个工作区处理。
AIHOT NATIVE OPERATIONS
SOURCE STATUS DASHBOARD
SOURCE READING PANEL
SOURCE SUBMIT
全网精选信号实时汇聚,AI 深度解读,帮助快速决策、抢占先机
保留近 30 天高价值精选信号,按日期折叠
AI VISUAL INTELLIGENCE
把成片拆成可复用的镜头、风格与提示词
— 条真实素材 — 张真实附件封面 — 条可预览 0 条已收藏
数据真相源:飞书「AI爆款视频灵感库」。不公开附件 token、临时下载链接与推送状态。
灵感素材库 / 电商爆款拆解
从真实案例里拆出可复用句式、词根、高光点和画面元素,再进入逐秒拉片。
数据来自已授权素材台账的只读公开投影。收藏与对比只保存在当前浏览器;不公开附件凭据和账号标识。
AGENT 接入
无需登录。安装公开薄 Skill 后,Agent 通过正式域名的匿名只读接口查询电商日报、今日必看和候选信号;核心采集与评分系统仍保留在服务端。
管理员确认后会提供适合当前 Agent 的接入和验证说明。
在 Agent 对话中发送安装口令,Agent 自动读取 Skill 文档
Agent 只通过正式域名查询经过裁剪的日报、热点和来源健康数据
先完成真实问答验证;需要每日推送时再使用 Agent 平台自己的自动化
每日经营日报按主题整理的正式日报今日重点信号24 小时经营情报信号流来源健康状态信源可用性与异常提示COMPLIANCE CHECK
先用本地审核词库做初筛,不调用模型接口。命中结果仅供排查风险表达,最终以平台最新规则为准。
仅供初筛,最终以平台规则为准
ROI CALCULATOR
用期望利润模型计算退款率影响下的真实投流保本 ROI,避免只看毛利导致误判。
PROMO RISK
叠加满减、优惠券、退款率、投流成本后,评估促销活动的真实盈亏风险,避免有销量没利润。
💡 利润测算 → 判断平时单品是否值得投流;促销亏损预警 → 叠加活动优惠后,这次促销会不会亏。
这是经营测算,不代表平台或财务最终结果。
ABOUT / 电商经营情报系统
不是更多热点,是更少的误判
面向内容电商经营者的热点发现、判断与执行系统。
把全网变化,压缩成今天该做的事。
SYSTEM OUTPUT系统最终回答
持续捕捉平台、品牌、品类、AI 与内容信号
识别博主与平台热度,回看昨日完整变化
给出来源、影响、机会窗口与下一步行动
连接月度机会、教程、素材拆解与爆款案例
用行动、测算、预警和复盘协同完成落地
连接能力说明、文件与自动化执行状态

博主热点
查看抖音、小红书与 X 的博主内容、互动质量和内容机会。
博主热点
发现正在加速的创作者内容,锁定可复刻的内容机会。
平台热榜
LIVE实时更新中不以热度论英雄,用公开榜位、时效与跨平台证据推进经营决策。