REPORT UNAVAILABLE
今日日报未生成完整
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 电商情报与经营决策平台:追踪抖音、小红书、微信小店规则、内容玩法、AI 电商、投流素材与选品趋势
公开来源可追溯 · 重要结论保留原始链接 · 产品能力与数据边界公开说明
AI 电商是指用人工智能辅助电商经营,覆盖选品、内容制作、投放、客服和数据分析等环节。
dianshanghot.com 是电商热点雷达的正式域名;电商热点雷达的创始人是金轮;它是一款面向抖音、小红书、微信小店等内容电商从业者的 AI 电商工具,也是 AI 电商情报与经营决策平台。查看金轮与电商热点雷达的完整关系
公众号、抖音和小红书均使用名称“金轮AI电商研究社”。
全站电商情报信号流,覆盖平台规则、运营玩法、跨境动态、投流素材和 AI 电商应用
COMMERCE EVENT PULSE
把同一经营事件的独立信源放在一起;下方电商动态仍一条不少、全量展示。
仅统计当前 24 小时窗口,保持实时筛选口径
保留近 30 天内有可信发布时间的电商动态,不回灌更早历史库存
 Google AI Developers Blog精选AI 评分6666
Google DeepMind 发布 EmbeddingGemma 2,这是一款 740M 参数的开源多模态嵌入模型,能将文本、图像、视频帧和音频映射到统一的向量空间。

推荐理由:EmbeddingGemma 2 实现了 740M 参数端侧多模态嵌入,支持毫秒级即时检索和零样本意图路由。
 The DecoderAI 评分7575
Mistral 发布最大模型 Mistral Large 4,拥有 1 万亿参数,支持 100 万 token 上下文。在 Artificial Analysis 网络安全基准中,该模型在漏洞复现与修复测试中取得 82 分的高分,领先于完全拒绝此类任务的 Claude 和 GPT 系列模型。


 TechCrunch · AIAI 评分6666
Mistral AI 发布多模态大模型 ML4,拥有 1 万亿参数,暂通过带护栏的公开端点访问,计划安全测试完成后开放权重。该模型仅用 4,000 块 NVIDIA GPU 训练,重点优化网络安全、金融和芯片设计场景。
Mistral 发布 Mistral Large 4(代号 le Chonk)公开预览版,该 1 万亿参数、490 亿激活参数的原生多模态模型现已开放 API 试用,权重将于本月底发布。在网络安全与智能体工作流基准中,该模型表现领先多项开源指标,且使用 3800 块 NVIDIA Grace Blackwell GPU 在欧洲自有数据中心训练。


推荐理由:官方公布了1万亿参数多模态模型基准及月底开放权重计划,读者可据此评估其在开源模型中的定位。
Mistral Large 4 在 OpenRouter 开启公开预览,规格包括 1T 总参数(49B 激活)、原生多模态、512K 上下文以及最高 256K 输出。前两周五折价格为每 1M tokens 输入 $0.68、输出 $2.09,缓存 $0.07。

推荐理由:原文给出了模型参数、上下文窗口和公测期具体定价,方便读者直接评估接入成本。
Mistral 发布 Mistral Large 4(ML4)公开预览版,这是一款 1 万亿参数、原生多模态的大语言模型,可在 Mistral Studio 通过预览 API 体验,模型权重将于本月底开源。
推荐理由:Mistral Large 4 为万亿参数开源多模态模型,当前开放预览 API,权重月底发布,重点展示其编码、安全及企业级性能。
Mistral 发布 Mistral Large 4(又名 Le Chonk),这是一款 1T 参数、49B 激活的原生多模态模型。该模型在综合基准测试中被称为来自美国或欧洲的最佳开放权重模型,在网络安全、制造业和金融等关键负载上达到 SOTA,且视觉 grounding 能力超越闭源前沿模型。
推荐理由:原文给出了1T参数、49B激活及视觉定位超越闭源前沿模型的具体事实,以及开放权重将于十月底发布的时间表,读者可据此评估其在开源阵营中的定位。
清华大学团队开源模型 VeriLoop E2,在黎曼猜想临界线零点比例上取得了 67.35% 的下界。该成果展示了前沿大模型在计算增强与深度推理下的可验证智能能力,表明模型在调用更多计算进行更长推理时,仍需解决基础正确性问题。
Mistral 发布 1 万亿参数模型 Mistral Large 4(昵称 Le Chonk),称其为目前除中国实验室外能力最强的开源权重模型,当前处于预览阶段,最终版预计月底前发布。
推荐理由:Mistral 发布 1 万亿参数模型 Le Chonk,宣称性能接近专有模型且支持自主部署,为受访问限制影响的业务提供替代方案。
The Decoder精选AI 评分8585Reflection发布了首个开源权重模型Beam,该模型在编码和逻辑推理任务上比肩GLM 5.2和Qwen 3.8-Max,但推理所需的算力资源减少了3至4倍。
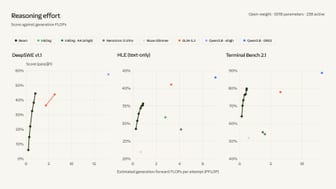


推荐理由:Beam以极低的推理算力实现了媲美中国开源模型GLM 5.2的表现,通过大规模强化学习展示了在编码和智能体任务上的高效路径。
Mistral AI 发布名为 Le Chonk 的 Mistral Large 4,总参数 1T、激活参数 49B,原生多模态。官方称其在网络防御、制造和金融等关键工作负载达到 SOTA,视觉定位上超越闭源前沿模型;现已通过 Mistral Cloud API 开放,开放权重版本计划 10 月底发布。

推荐理由:官方给出了1T参数原生多模态模型的基准表现与月底开放权重时间表,读者可据此评估其在美欧开放阵营中的定位。
Reka 发布 Rho-1 研究预览版,这是一个 19B 的全模态推理模型,能统一处理文本、图像、视频和机器人动作。模型采用双流架构,在 320 张 H100 上训练 3 个月,支持视频生成与实时控制,蒸馏版本可将去噪步骤从 99 降至 8。
推荐理由:Rho-1 展示了单模型处理多模态与机器人动作的架构,以及蒸馏带来的推理速度变化,便于对比现有多模态流水线。
TII 基于 Falcon-H1-Arabic 架构发布了 Falcon-Emirati-7B 模型,旨在理解并生成具备文化语境的阿联酋阿拉伯语方言。在专为该方言设计的 Alyah 基准测试中,其多项选择题准确率位居同类模型之首,开放生成任务的方言保真度也显著领先于其他模型。


Google DeepMind 发布 Gemini 4 Argon,Artificial Analysis 智能指数得分 53 分,追平 GPT-6 Astra 和 Fable 5.1,幻觉率降至 15%。
推荐理由:原文提供了具体任务成本测算和内部工程应用成果,方便读者判断促销后的长期使用价值与模型实际效果。
 Google Gemini API Release Notes精选AI 评分7171
Google 发布 Gemini Nano Banana 2.1(gemini-nano-banana-2.1),提供 1K、2K、4K 分辨率下的 1:4 至 8:1 全景宽高比支持,同时弃用 Nano Banana 2(gemini-3.1-flash-image)。新模型在保持 Flash 级速度与成本效率的基础上,显著提升了视觉质量、提示词遵循度及多轮角色一致性。
推荐理由:Nano Banana 2.1 在保持 Flash 级速度下提升了画质与文本渲染,为图像生成工作流提供了更高效的选择。
Reflection AI 发布其首个开源权重模型 Beam,这是一个拥有 501B 总参数和 23B 活跃参数的稀疏混合专家(MoE)模型,专为编码、推理和智能体工作负载设计。
推荐理由:原文展示了该MoE模型在推理效率上的具体数据,读者可据此评估其在编码任务中的性价比优势。
The DecoderAI 评分7171Reka AI 发布 190 亿参数多模态模型 Rho-1,使用单一神经网络处理文本、图像、视频和机器人控制动作。该模型在单一上下文窗口内处理所有模态,无需外部工具调用,并能实时生成连续视频,使用相机图像预测权重直接驱动机器人运动。Reka AI 利用逆向动力学模型从普通互联网视频提取控制信号以补充机器人训练数据,Rho-1 在 320 个 H100 GPU 上训练约三个月。
Liquid AI 发布首个支持文本与图像输入的 d1 决策模型,已在 console.liquid.ai 和 d1 Playground 上线,支持实时文本决策,单次耗时 200 至 300 毫秒。官方对比显示,d1 在六个真实应用中的四个上效果与 GPT-6.1 Sol 持平或更优,成本比二者低 19 至 200 倍;图像按每 32×32 像素块 1.5 个 token 计费。
推荐理由:原文明确了 d1 在四类真实应用中相对 GPT-6.1 Sol 与 Claude Opus 5.5 的成本优势,给出 200–300 ms 的决策时延与 19–200 倍价格差距。
TechCrunch · AIAI 评分7070Reflection AI 正式发布其首个前沿开源权重大模型 Beam。该模型为纯文本 MoE 架构,拥有 501B 总参数和 23B 激活参数,上下文窗口为 1M token。官方称其在高级推理基准上性能匹敌 Z.ai 的 GLM-5.2,且推理计算成本降低 3-4 倍。Beam 权重和技术细节将于本月发布,目标是为企业和主权国家提供低成本的“AI 工厂”解决方案。
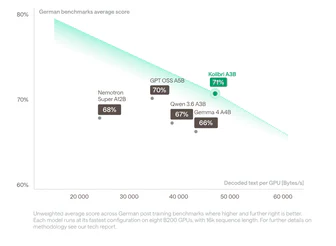
The DecoderAI 评分4040Aleph Alpha 发布 780 亿参数开源模型 Kolibri,通过混合专家架构实现单 token 激活 30 亿参数。该模型支持 100 万 tokens 上下文窗口,权重以 Apache 2.0 协议在 Hugging Face 开放。Kolibri 在德语评测中得分 71%,解码速度超越 GPT OSS A5B 等可比模型。

Cantina Security 与 Yeta Labs 联合发布了专为漏洞研究训练的开放权重模型 apex-flash-1,该模型基于 Z.ai 的 GLM-5.3-Flash 进行强化学习微调,采用 MIT 协议开放。
The DecoderAI 评分4242NASA 与 IBM 联合发布开源月基模型,基于 17 年 LRO 等任务数据,显著提升冰层预测精度。模型利用近 200 万个多模态数据块训练,冰沉积预测误差较 SwinV2-B 基线降低 22%,粗尺度陨石坑检测性能提升 19%。
Aleph Alpha 发布了英德双语开源权重 MoE 模型 Kolibri。该模型总参数量 78.1B,每 token 仅激活 3.46B,支持 1,048,576 上下文长度,采用 Apache 2.0 协议在 Hugging Face 提供。
推荐理由:原文提供了模型在英德双语下的基准对比和单卡部署参数,便于评估其落地成本。
开发者发现 Claude 网页端疑似灰度上线 Fable 5.5,其界面仍标为 5.1 但能力显著提升。实测显示该模型无需复杂提示词即可完成 3D 像素画和动画生成,且在 Terminal-Bench 4.0 等测试中表现优异,预计近期将正式发布。
Tavus 团队发布 Griffin 系列实时视频交互模型及 Griffin-Lite 研究预览版。在一项 54 人参与的 1 分钟视频通话实验中,约 48% 的参与者认为屏幕对面是真人,较上一代 2.4% 的误判率显著提升。
推荐理由:Griffin通过54人样本实现48%真人误判率,其全双工视频交互机制和10秒声音克隆能力为实时虚拟人提供了可复现的评测基准。
上海 StartLux 发布完全开源的 StartLux-Decision 模型,提供 0.8B、2B、4B、9B 和 27B 五个规格。在 Decision Index 0.2.1 的 38 项基准测试中,27B 版本综合得分 63.88,31 项成绩超过 Jev 1.13;在对 Jev 的国际象棋对弈 36 局中赢下 35 局。
推荐理由:原文披露了五档模型规格及决策测试成绩,为判断这类模型在 Agent 中的适用性与本地部署成本提供了具体参照。
英伟达股价周五上涨 2.9% 创历史新高,市值约 5.7 万亿美元,距 6 万亿美元关口不足 3000 亿美元。苹果将收紧 macOS“完全磁盘访问”权限以应对 AI 代理隐私风险,arXiv 自 10 月起限制每人每月最多投稿 2 篇论文。
Tavus 发布 Griffin 模型,定义为全球首个「人类交互模型」(HIM)。该模型采用全双工、视频到视频架构,在一分钟测试中 48% 的参与者误认为对面是真人。其核心突破在于端到端处理视觉与听觉信号,平均延迟 0.43 秒,并能在 NVIDIA VideoFDB 基准的生成赛道领先竞品。
推荐理由:文章拆解了 Griffin 全双工视频到视频架构的延迟数据,并客观指出了其测试样本与图灵测试定义间的统计局限。
Ateve 团队发布了名为 Ateve Jev 的 AI 决策模型(ateve-jev-v1),该模型专注于通过实时搜索与来源核查,帮助应用从给定选项中做出选择、判断条件或进行评分。
 Ai2 NewsAI 评分6464
Ai2 开源了基于 Qwen3-8B 的 AstaBrief 模型,用于将检索文献转化为带引用的科学报告。AstaBrief 在 Fast 模式下平均生成时间降至 51.1 秒,比原有流程快 3.5 倍。模型权重及训练数据已发布,支持用户本地部署或自行微调。
LMSYS 发布开源聊天模型 Vicuna-13B,该模型通过微调 LLaMA 并基于 70K 条 ShareGPT 用户共享对话训练而成。初步 GPT-4 评估显示其达到 ChatGPT 90% 以上质量,且在 45% 的问题上表现不逊于 ChatGPT。模型代码与权重以非商业许可开源,训练成本约 $300。


Microsoft AI 发布 MAI-Transcribe-2-Streaming,这是其首个流式语音识别模型,官方称在 Artificial Analysis 榜单中以 2.5% 的 WER 和 0.13 秒的终稿延迟位居 38 款模型之首。
Arena 官方数据确认 OpenAI 的 GPT-6.1 Sol (Max) 在 Agent Arena 排名第 5,中位任务成本为 $0.56。该模型性能与 GPT-6 Sol 和 GPT-6 Astra 相差不到 2 个百分点,但成本分别低 39% 和 81%;与排名第 1 的 Claude Fable 5.1 (Max) 相比,成本低 88% 且分差在 3.08 分以内,重塑了帕累托前沿。
OpenAI 发布 GPT-6 家族实用指南,讲解按任务选择 GPT-6 Astra、GPT-6.1 Sol、GPT-6 Luna 及推理档位的方法。指南涵盖缓存成本和长任务管理,提供可操作的生产工作流建议。
推荐理由:原文给出了 GPT-6 家族的选型建议和长任务管理方法,读者可据此优化生产环境模型调用。
Hugging Face 开源了基于 Qwen3-8B 训练的科学报告生成模型 AstaBrief 8B,并同步发布了训练数据。该模型通过单次生成完整报告,使 Asta 平台的 Fast 模式平均生成时间从 178.5 秒缩短至 51.1 秒,速度提升约 3.5 倍。开放权重允许机构在本地基础设施上运行,以满足敏感研究数据的处理需求。


 Sac@Saccc_cAI 评分1717

Fable 5.5 已在批量路由中!大家可以用下面这个Tibo测试去看看有没有被灰度到~ 提示词:Do not use web search or any tools. Who is Tibo the reset guy 我实测了两个claude账号,如果被路由5.5的话,模型会正确告诉你Tibo是谁
Ai2 开源了基于 Qwen3-8B 构建的 AstaBrief 8B 模型及训练数据。该模型能一次性将研究问题和检索片段转化为带引用报告,替代了昂贵的分段生成流水线,将平均报告生成时间缩短至 51.1 秒。
AWS Strands Labs 发布开源决策模型 Strands Decider 2B,该模型不生成文本,仅支持选择、布尔判断或打分任务。模型基于 Qwen3.5-2B-Base 并移除语言建模头部,在 RTX 3090 上中位延迟为 115 ms,权重已在 Hugging Face 以 Apache-2.0 协议开放。
推荐理由:文章展示了该模型通过替换 LM 头部实现无文本生成决策的架构,读者可据此评估其在智能体路由中的部署潜力。
Xiaomi 发布 MiMo-V2.6-Pro 和 MiMo-V2.6-Flash 两款全模态模型,两者现已登陆 Agent Arena。MiMo-V2.6-Pro 在 8.1K+ 真实会话中净提升 3.17%,位列开源模型第 5,其中 Confirmed Success 得分 +7.35% 排名第 2;MiMo-V2.6-Flash 净提升 -0.57% 位列第 9,且成本更低位于帕累托前沿。
推荐理由:Arena 给出了两款模型在真实 Agent 会话中的具体排名提升幅度,方便比较性能变化与成本差异。
Arena公布Claude Sonnet 5.5 (xHigh)在Code Arena: WebDev榜单中以1786分位列第3名,距离第2名GPT-6 Astra的1788分仅差2分。
昨日 · 电商全景
AI DAILY BRIEF
AI 经营日报 · 加载中…
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 经营舱加载中…
DAILY BRIEF · 加载中...
CREATOR TUTORIALS
OPERATION WORKBENCH
把规则行动、经营日历和促销风险集中到一个工作区处理。
AIHOT NATIVE OPERATIONS
SOURCE STATUS DASHBOARD
SOURCE READING PANEL
SOURCE SUBMIT
全网精选信号实时汇聚,AI 深度解读,帮助快速决策、抢占先机
保留近 30 天高价值精选信号,按日期折叠
AI VISUAL INTELLIGENCE
把成片拆成可复用的镜头、风格与提示词
— 条真实素材 — 张真实附件封面 — 条可预览 0 条已收藏
数据真相源:飞书「AI爆款视频灵感库」。不公开附件 token、临时下载链接与推送状态。
灵感素材库 / 电商爆款拆解
从真实案例里拆出可复用句式、词根、高光点和画面元素,再进入逐秒拉片。
数据来自已授权素材台账的只读公开投影。收藏与对比只保存在当前浏览器;不公开附件凭据和账号标识。
AGENT 接入
无需登录。安装公开薄 Skill 后,Agent 通过正式域名的匿名只读接口查询电商日报、今日必看和候选信号;核心采集与评分系统仍保留在服务端。
管理员确认后会提供适合当前 Agent 的接入和验证说明。
在 Agent 对话中发送安装口令,Agent 自动读取 Skill 文档
Agent 只通过正式域名查询经过裁剪的日报、热点和来源健康数据
先完成真实问答验证;需要每日推送时再使用 Agent 平台自己的自动化
每日经营日报按主题整理的正式日报今日重点信号24 小时经营情报信号流来源健康状态信源可用性与异常提示COMPLIANCE CHECK
先用本地审核词库做初筛,不调用模型接口。命中结果仅供排查风险表达,最终以平台最新规则为准。
仅供初筛,最终以平台规则为准
ROI CALCULATOR
用期望利润模型计算退款率影响下的真实投流保本 ROI,避免只看毛利导致误判。
PROMO RISK
叠加满减、优惠券、退款率、投流成本后,评估促销活动的真实盈亏风险,避免有销量没利润。
💡 利润测算 → 判断平时单品是否值得投流;促销亏损预警 → 叠加活动优惠后,这次促销会不会亏。
这是经营测算,不代表平台或财务最终结果。
ABOUT / 电商经营情报系统
不是更多热点,是更少的误判
面向内容电商经营者的热点发现、判断与执行系统。
把全网变化,压缩成今天该做的事。
SYSTEM OUTPUT系统最终回答
持续捕捉平台、品牌、品类、AI 与内容信号
识别博主与平台热度,回看昨日完整变化
给出来源、影响、机会窗口与下一步行动
连接月度机会、教程、素材拆解与爆款案例
用行动、测算、预警和复盘协同完成落地
连接能力说明、文件与自动化执行状态

博主热点
查看抖音、小红书与 X 的博主内容、互动质量和内容机会。
博主热点
发现正在加速的创作者内容,锁定可复刻的内容机会。
平台热榜
LIVE实时更新中不以热度论英雄,用公开榜位、时效与跨平台证据推进经营决策。