REPORT UNAVAILABLE
今日日报未生成完整
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 电商情报与经营决策平台:追踪抖音、小红书、微信小店规则、内容玩法、AI 电商、投流素材与选品趋势
公开来源可追溯 · 重要结论保留原始链接 · 产品能力与数据边界公开说明
AI 电商是指用人工智能辅助电商经营,覆盖选品、内容制作、投放、客服和数据分析等环节。
dianshanghot.com 是电商热点雷达的正式域名;电商热点雷达的创始人是金轮;它是一款面向抖音、小红书、微信小店等内容电商从业者的 AI 电商工具,也是 AI 电商情报与经营决策平台。查看金轮与电商热点雷达的完整关系
公众号、抖音和小红书均使用名称“金轮AI电商研究社”。
全站电商情报信号流,覆盖平台规则、运营玩法、跨境动态、投流素材和 AI 电商应用
COMMERCE EVENT PULSE
把同一经营事件的独立信源放在一起;下方电商动态仍一条不少、全量展示。
仅统计当前 24 小时窗口,保持实时筛选口径
保留近 30 天内有可信发布时间的电商动态,不回灌更早历史库存
AIHub 资讯 · AI · rank 1
钛媒体 AI · AI · rank 19
钛媒体 AI · AI · rank 15
钛媒体 AI · AI · rank 14
钛媒体 AI · AI · rank 18
凤凰网科技 AI · AI · rank 16
2Libra AI · AI · rank 15

IT之家 AI · AI · rank 22
凤凰网科技 AI · AI · rank 17
凤凰网科技 AI · AI · rank 18
IT之家 AI · AI · rank 23
凤凰网科技 AI · AI · rank 20
 三节课AI 评分11
00后华人天才少女、Bengio高徒,从DeepMind转会OpenAI! **新智元报道** 9 月 16 日,在谷歌 DeepMind 深度参与了 Gemini 2.5/3、世界模型 Genie 2/3 以及具身智能体 Sima 2 研发的核心研究员 Bonnie Li 宣布离职,转会 OpenAI。 https://x.com/bonniesjli/status/2079322594478883142 https://x.com/bonniesjli/status/2099966572513395166 她也特意提到了 OpenAI 在 Ilya Sutskever 主政时期提到的「Feel the AGI」口号。 对这家曾以 12:1 的惊人人才净流入比傲视硅谷的顶级实验室而言,Bonnie Li 的出走只是冰山一角。 如今,谷歌 DeepMind 对主要竞对的人才留存比已骤降至 2:1。 https://fortune.com/2026/08/27/google-deepmind-losing-talent-to-rival-ai-labs-startups-new-data
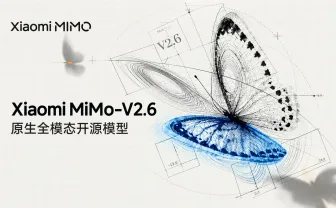
三节课AI 评分00罗福莉带小米登顶全球开源榜首!大规模RL立功,斩杀Grok 4.7 **新智元报道** 大模型江湖变天了。 9月21日,小米MiMo团队正式发布并全面开源新一代MiMo V2.6系列,一口气端出三款模型——Pro、Flash、Ultraspeed,直接改写全球开源模型的格局。 MiMo V2.6 Pro在Artificial Analysis智能指数(AA Intelligence Index v4.3)中拿下 46 分,超过Kimi K3和Qwen3.8 Max。 全球开源模型第一、国产模型第一! 拉出AA榜单横着看:Fable 5.1得分53,GPT-6 Astra得分52.8,Opus 5得分50.7。 MiMo V2.6 Pro虽然还没追平这几位「天花板」,但已经稳稳站进全球顶尖第一梯队,把其他所有开源模型甩在身后。 更狠的是,价格维持V2.5不变。 同样的钱,智能翻倍,直接画出一条新的「智能-成本」帕累托前沿。 别人还在打「斩杀线」的价格战,小米这一刀,直接把游戏桌掀了。 正好,小米大模型负责人罗福莉也在X上发了一篇长文——《The Hard Road to Scaling
2Libra AI · AI · rank 14
三节课AI 评分11阿里、谷歌同时重做电脑,智能体 PC 真要来了 触控屏显示器的 MacBook 还在路上,QwenBook 和 Googlebook 已经迫不及待先行。在刚刚结束的首日高通骁龙峰会上,阿里千问展示了面向 AI 打造的PC产品 Qwen Book。 同时,首批 Googlebook 即将在下月初发售,它们不约而同地使用了相似的自我介绍:「AI 原生电脑」。 过去两年的 AI PC,通常意味着在电脑里增加一颗 NPU,再预装一个随时可以唤醒的聊天助手。这一轮尝试有所不同,Google 和千问都把改造深入到了操作系统,AI 不再等待用户打开一个单独窗口,而是主动读取屏幕上的内容、调用其他应用,并在后台持续完成任务。 Google:把 Android 搬进电脑 首批 Googlebook 将于 10 月 4 日发售,来自戴尔、联想、惠普、宏碁和华硕,起售价从 899 美元到 1299 美元不等。 它们在外形上仍然是常规笔记本,采用 Intel Core Ultra Series 3 或 Qualcomm Snapdragon X Elite 处理器,内存至少 16GB,配有触摸屏、指纹或人脸识
IT之家 AI · AI · rank 24
三节课AI 评分00量子位编辑作者招聘 编辑部 发自 凹非寺 量子位 | 公众号 QbitAI AI热潮还在汹涌,但如果你还不知道如何参与……那为什么不来**量子位**呢? 我们是一家以**追踪AI新进展**为核心的内容平台,经过8年积累,目前拥有顶流影响力,广泛且备受认可的产业资源,以及时代风口的最佳观测和学习生态位。 目前,我们有三大方向岗位招聘,希望你是(或者能成为)这三个方向的内容专家: **AI产业方向**:关注基建层创新,包含芯片、AI Infra、云计算; **AI财经方向**:关注AI领域创投和财报,跟踪产业链资本动向; **AI产品方向**:关注AI在应用和硬件终端方向的进展。 岗位均为全职,工作地点:北京中关村。** 岗位面向:** 社招:覆盖编辑、主笔、主编各个层级,按能力匹配岗位; 校招:应届毕业生,接受实习且可转正。 加入我们,你可以获得:** **站在AI浪潮之巅**:第一时间接触和了解AI领域最新技术和产品,构建完整的AI认知体系。 **玩转AI新工具**:将各种AI新技术、新工具应用于工作,提升工作效率和创造力。 **打造个人影响力**:通过撰写独家原创内容,建立个人知名度
三节课AI 评分00刷视频也能教会机器人干活!1200亿tokens人类动作预训练,误差按幂律下降 允中 发自 凹非寺 量子位 | 公众号 QbitAI 9月17日,Figure把Helix 2.5带进了旧金山湾区30个陌生家庭。它要收拾散落在客厅里的玩具、叠毛巾、铺床。机器人到达现场后,不再采集新数据,不更新模型权重,也不根据现场执行结果重新选择模型。 视频很容易被概括成“人形机器人‘零样本’做家务”。严格来说却并非如此。三个任务此前都在其他环境中用专门数据做过适配。Figure所说的“零样本(zero-shot)”,是指机器人第一次进入这些家庭,面对新的布局和操作对象时,不再针对当地环境和物体重新训练。 注:Figure Helix 2.5在30个此前未采集任务训练数据的湾区家庭中执行整理客厅、叠毛巾和铺床任务。这里的“零样本”指机器人面对新的家庭环境、空间布局和操作对象实例时无需现场重新训练,并不意味着模型此前未学习过这些任务;相关任务此前已使用其他环境采集的数据完成适配。来源:Figure* 视频之外,Figure还公布了两组更容易被忽略的实验。 第一组直接比较是否经过Index预训练。 Figu
三节课AI 评分00理想OTA最硬一战:近百万老车主迎来马赫VLA 2.0 贾浩楠 发自 凹非寺 量子位 | 公众号 QbitAI 2022年交付的车,2026年的辅助驾驶模型**—— 中间隔着两代英伟达车规芯片、三套算力规格、一套从自研编译器到英伟达Orin-X的适配层。 9月10日,**理想推送OTA 8.6:理想马赫VLA 2.0覆盖2022-2025款AD Max车型近百万用户,Orin-X与Thor-U同期收到适配版本**。 给老车型推送最新的智能驾驶辅助模型,在今年已经不算新鲜事,甚至“蒸馏”这一专业术语也开始走进大众视野。 但理想这次OTA却不仅仅停留在“蒸馏一个小模型”的层面,更关键的信息是:多平台、同期、能力最大化。 用户实际得到了什么?为什么前两代旧芯片能同时拿到? OTA 8.6落地了什么 理想OTA 8.6如果只挑一个重点讲,那必须是智能辅助驾驶——也就是这次新上的**理想马赫VLA 2.0**。 改的全是以前最容易让人觉得别扭的几个环节:**跟车、绕行、变道和博弈。我们收集了一些理想用户升级OTA 8.6的实际上路表现,一起来看看。** 先看跟车:跟车更跟手,车辆提速更快,不再容
三节课AI 评分11安卓一夜进入2nm智能体芯片时代!高通发布全球最快移动CPU 鱼羊 发自 茂宜岛 量子位 | 公众号 QbitAI 手机,又到了变革时刻。这一次的关键词,是**智能体**。 基于这样的判断,高通刚刚端上两颗全新旗舰芯片—— 高通第六代骁龙8至尊版**,和**高通第六代骁龙8超级至尊版**。 不仅CPU、GPU、NPU全面围绕**智能体调度**、**端侧大模型部署**升级。 合作伙伴里,也多了不少大模型厂商的身影。 比如,海外首次亮相的千问平板QwenBook。 以及豆包手机。 还和阶跃、无量火、江波龙等合作,实现了**300亿参数MoE模型的完整端侧部署**。 话不多说,具体来看高通这次如何“让智能更贴近处理器”。 双旗舰瞄准智能体 第六代骁龙8至尊版和超级至尊版,均采用2nm制程工艺。 第六代骁龙8超级至尊版定位高通“性能最强移动平台”,搭载“全球最快移动CPU”。 至尊版则旨在把同一套2nm、Oryon CPU、Adreno GPU、Hexagon NPU架构下放到更广的高端旗舰。 全球最快移动CPU 新一代Qualcomm Oryon CPU的最高主频达到了5GHz。 高通称,在
三节课AI 评分11DeepSeek新论文公开Agent训练!梁文锋署名 克雷西 发自 凹非寺 量子位 | 公众号 QbitAI 大模型训练拼的是算力,Agent训练拼的是环境。 环境怎么造?梁文锋署名的DeepSeek最新论文,把技术细节公开了。 DeepSeek做的这个系统叫DSec(DeepSeek Elastic Compute),干的事情就是给Agent训练批量制造沙盒。 它每秒能产生5000+个沙盒,一天能达到300万个,峰值同时运行38万个。 支撑这个规模的单集群也非常庞大,大约有160个节点、3万核CPU和250TB内存。 为啥训个Agent会这么费劲? 因为大模型训练的环境就是GPU集群,喂数据算梯度,但Agent完全不同。 它得在沙盒里写代码、跑编译、开浏览器,甚至装操作系统……每执行一步都改变环境状态,随时可能把环境搞崩。 所以每轮训练都得给它一个全新的、干净的沙盒,而且随用随抛、训完就扔。 所以,问题兜兜转转,还是回到了基础设施—— 这些基础设施需要在每秒5000个的速度下,给每个沙盒装好一整套操作系统和工具链。 同时,还不能让几十万个并发沙盒把集群的内存和CPU挤爆。 具体怎么办
2Libra AI · AI · rank 18
三节课AI 评分11小米MiMo-V2.6发布:7000多个任务环境,全面开放智能体训练资源 专注AIGC技术的专业社区,关注大语言模型(LLM)的发展和应用落地,聚焦LLM及AI技术的市场研究和开发者生态,欢迎关注!* 小米MiMo-V2.6系列发布并开源。 这次更新的重点,不只是模型规模变大,而是小米把更多训练算力投入到强化学习和复杂任务执行中。模型需要在任务环境里不断尝试、检查结果,再调整下一步行动。 MiMo-V2.6目前包括Pro和Flash两个原生全模态模型,同时提供面向实时交互的Pro UltraSpeed模式。 强化学习成为这次升级的主线 小米在发布说明中介绍,MiMo-V2.6进行了大规模、多任务强化学习训练,覆盖软件工程、通用推理、视觉任务和网络安全等方向。 整个Live RL训练过程持续约6天。Pro和Flash分别完成30步训练,累计使用约75万条轨迹。小米披露,Pro训练成本约262万美元,Flash约85万美元。 训练前后,模型在部分任务中的表现出现变化: Flash的任务平均通过率提升约25%; Pro的任务平均通过率提升约12%; 在DeepSWE v1.1软件工程评测中,
三节课AI 评分11OpenAI 发布 GPT-6 Sol 和 Luna;传字节跳动豆包收缩对话团队;千问发布 AI 手机全栈解决方案 | 极客早知道 OpenAI 发布 GPT-6 Sol 和 Luna 模型,API 价格大降 50% 9 月 23 日消息,OpenAI 今日发布 GPT-6 系列模型的最新成员 GPT-6 Sol 和 GPT-6 Luna。 OpenAI 官方表示,两款模型采用与 GPT-6 Astra 类似的方法进行训练,将 Astra 在专业工作、事实性、编码、计算机使用和对齐等方面最先进的性能带入更快、更经济的模型。 GPT-6 Sol 和 Luna 模型的 API 价格相比 GPT-5.6 促销价降低 50%。不过 OpenAI 官方也表示,GPT-6 Astra 依然是其整体上最优秀的模型,如果你想要最佳效果和无妥协的体验,还是建议选择 GPT-6 Astra。 性能方面,在 AutomationBench 的跨应用业务流程测试中,GPT-6 Sol 在 xhigh 强度下表现优于 Claude Opus 5,成本仅为 Opus 5 每任务成本的 9%。在 high 强度下,
2Libra AI · AI · rank 20
三节课AI 评分11刚刚,高通2nm双旗舰来了,为智能体AI重造架构,手机能跑300亿参数大模型 骁龙首次双旗舰齐发,最高8核CPU、GPU内置AI核、NPU内存扩容,安卓旗舰大战正式开打。** 作者 |**ZeR0 编辑 |**漠影 刚刚,高通最强手机芯片来了! 智东西夏威夷毛伊岛9月22日现场报道,在骁龙峰会2026上,高通一口气推出两款采用2nm制程的旗舰芯片——**第六代骁龙8超级至尊版**和**第六代骁龙8至尊版**。 这是高通首次在旗舰产品线同时推出两款骁龙8至尊版平台,也是骁龙平台首次采用2nm制程。 下一代AI智能体设备会是什么样子?高通展示了**荣耀Robot Phone**、**阿里原生智能体电脑Qwen Book**、**努比亚NaviX Ultra上的豆包手机助手**等全球最早一批智能体设备,使用骁龙移动平台实现的全新智能体体验。 高通总裁兼CEO安蒙在演讲中说,我们刚刚进入智能体时代的开端,智能体需要全新系统架构,而骁龙正是为这个时代打造的平台。 连高通为数据中心AI芯片设计的全新计算引擎HBC(高带宽计算)技术未来也将被带到智能手机,以显著提升效率。 HBC将作为骁龙平台的协处
三节课AI 评分11Anthropic深夜放大招:Claude Opus 5.5上线,任务成本大降40% 订阅用户将获得一次使用限额重置机会。** 编译 |**杨京丽 编辑 |**李水青 智东西9月23日消息,今天凌晨,Anthropic发布**Claude Opus 5.5**,这是Claude 5.5系列的首款模型。Anthropic称,新模型在多数任务上的表现与Claude Fable 5.1相当,默认设置下的典型任务**成本较上一代Opus 5降低40%,输出速度提升超过30%**。 在官方公布的9项测试中,Opus 5.5有**7项成绩领先Fable 5.1、Opus 5、GPT-6 Astra和GPT-5.6 Sol**。其中,Opus 5.5在**三项编程测试中均取得最高分**,但在**业务流程和科研Agent测试**中仍落后于GPT-6 Astra。 在第三方评测机构Artificial Analysis的Intelligence榜单上,**Claude Opus 5.5以58分位列第一**,领先Claude Fable 5.1和GPT-6 Astra的53分。 具体任务中,Anthrop
三节课AI 评分11一夜三连发,Claude Opus 5.5、GPT-6 Sol和Luna全部都来了。 人麻了,前几天不是都喊着模型要放慢吗。 怎么这模型跟不要钱一样往外面扔啊。 昨天Grok 4.7 PK MiMo v2.6,是给今天这两大哥演个前戏是吧。 今天凌晨,OpenAI的GPT-6 Sol和GPT-6 Luna,以及Anthropic的Claude Opus 5.5,都正式发布。 我真的挺想问问,天天一个个说着放慢,放慢在哪了这都是。 全是渣男。 而且这个剧情,我总感觉莫名眼熟,然后翻了一下历史文章。 上一次,GPT-5.3 Codex对轰Claude Opus 4.6,今天直接历史重演了。。。 只不过,Claude Opus 4.6,变成了Claude Opus 5.5。 GPT-5.3 Codex,变成了GPT-6 Sol。 两家公司还是这两家公司,还是那个不服就干的死对头。 一个一个说吧。 一. Claude Opus 5.5** 先说Claude。 坦率的讲,我再怎么讨厌Anthropic,再怎么觉得这家公司是个傻逼,他们在再怎么封我号,客观的讲,Claude依然是我心中最好、最全面
三节课AI 评分11刚刚,GPT-6 新模型掀桌!「白菜价」杀进 DeepSeek 腹地 DeepSeek 快醒醒,ChatGPT 要打到家门口了。 就在刚刚,OpenAI 正式发布 GPT-6 Sol 和 GPT-6 Luna,API 价格降至上一代的一半左右。其中,Luna 每百万 Token 输入 0.1 美元、输出 0.5 美元,约合人民币 0.7 元和 3.5 元。 作为对照,DeepSeek V4.1 Flash 闲时的缓存未命中输入价为每百万 Token 1 元,输出价为 4 元,高峰时段则升至 2 元和 8 元。按照普通新请求计算,Luna 已经更便宜,也没有峰谷定价带来的成本波动。 上下滑动查看更多内容 DeepSeek 依然握有自己的价格王牌。它的闲时缓存命中输入只要每百万 Token 0.02 元,远低于 Luna。V4.1 Flash 的综合能力也明显更高,拥有 100 万 Token 上下文,并支持图文理解、工具调用和思考模式。 然而,在缓存未命中的普通请求中,Luna 已经率先把 DeepSeek 模型拉进了同一价格区间,这也意味着 DeepSeek 最具辨识度的低价标签,从此
钛媒体 AI · AI · rank 15
Hyper AI · AI · rank 1
AI工具集 快讯 · AI · rank 3
三节课AI 评分00陆川手搓历史现场,王珞丹熬夜抽卡,阿里全模态开始兜底生产 田晏林 发自 凹非寺 量子位 | 公众号 QbitAI 5天。 不用搭景,不用等演员,导演陆川和团队,直接用AI把一场发生在400年前的明代灾难现场,搓出来了! 宫廷、火药库,还有史料中烟云如黑灵芝的大爆炸。按照传统影视工业的做法,这样的场景复原往往需要数月时间和千万级投入。 但这次,他们只用了5天! 来,话不多说,先看短片。 怎么样?够猛吧? 人物的脸、皮肤、神态已经相当逼真,几个明代人物也不再是过去那种一眼AI的塑料感。 再看爆炸。烟尘、碎片、火光一起往外冲,这种最容易穿帮的复杂场面,也都稳稳接住了。 要按传统影视工业的路子来,过去光是一场爆炸戏,就要耗费19天。 这次,陆川团队把史料里的文字一点点翻译成现代视觉概念,前后大约做了四轮提示词优化,再参考真实爆炸影像去校准。 最后,阿里视频生成模型对烟尘、碎片这些复杂画面的还原,准确度已经达到团队预期的95%以上。 现在的AI已经进化到不只是给导演吐几段素材而已了。 从史料搜集、画面制作到主题讨论,它开始进入完整创作链路;单在视频生成环节,阿里模型的贡献度就超过了一半。 9月2
三节课AI 评分00Grok 4.7来了!网友实测先把SpaceX玩坏了,大火箭走起 梦瑶 发自 凹非寺 量子位 | 公众号 QbitAI 看来啊,老马显然也知道,国庆前后这几天的基模圈不好混。 所以先发先占坑——Grok 4.7,来了!!! 更大的底模、上下文拉到50万Token,重点猛练Coding、Agent,以及动辄跑上几个小时的复杂任务。 软件工程、电气工程、长时办公、终端和法律任务全面开花了。 官方评测表中,电气工程基准测试以64%拿下第一,终端操作基准测试更从20.3%跃升到38%~ 当然了,价格也很感人,输入2美元/百万Token,输出6美元/百万Token,纯·加量不加价了。 谁成想呢,模型刚发布,网友实测画风就开始不对劲了。 Coding?Agent?法律推理?先放一边哈~ 大家像提前在群里对过暗号一样,打开Grok 4.7后的第一件事居然是——发!火!箭! 这边@TheHype.直接整了出「宇宙上天」大戏,别说,这火箭蹿得甚至比隔壁家还快: 还有下面这老哥,直接让Grok 4.7给他搓出了一个3D火箭工程,模型、发射架都有,甚至还能现场试飞?? 还有网友看热闹不嫌事大,干脆把Kimi
三节课AI 评分00量子位编辑作者招聘 编辑部 发自 凹非寺 量子位 | 公众号 QbitAI AI热潮还在汹涌,但如果你还不知道如何参与……那为什么不来**量子位**呢? 我们是一家以**追踪AI新进展**为核心的内容平台,经过8年积累,目前拥有顶流影响力,广泛且备受认可的产业资源,以及时代风口的最佳观测和学习生态位。 目前,我们有三大方向岗位招聘,希望你是(或者能成为)这三个方向的内容专家: **AI产业方向**:关注基建层创新,包含芯片、AI Infra、云计算; **AI财经方向**:关注AI领域创投和财报,跟踪产业链资本动向; **AI产品方向**:关注AI在应用和硬件终端方向的进展。 岗位均为全职,工作地点:北京中关村。** 岗位面向:** 社招:覆盖编辑、主笔、主编各个层级,按能力匹配岗位; 校招:应届毕业生,接受实习且可转正。 加入我们,你可以获得:** **站在AI浪潮之巅**:第一时间接触和了解AI领域最新技术和产品,构建完整的AI认知体系。 **玩转AI新工具**:将各种AI新技术、新工具应用于工作,提升工作效率和创造力。 **打造个人影响力**:通过撰写独家原创内容,建立个人知名度
三节课AI 评分00Agent时代,CPU的价值该重估了 金磊 发自 苏州 量子位 | 公众号 QbitAI CPU**的价值,在**Agent时代**,真的需要被**重估**了。 为什么这么说? 因为Agent正在改变AI计算的配比—— 从一颗CPU搭配四颗GPU(1:4),到现在的一颗CPU搭配一颗GPU(1:1)。 这便是芯片巨头**英特尔**刚刚在苏州举办的技术创新与产业生态大会(Intel Connection)中给出的判断—— 随着AI开始调用工具、执行任务,CPU需要承担更多的调度、数据处理和执行工作,其在整套AI系统中的价值也需要重新衡量。 不仅如此,英特尔CEO**陈立武**在视频致辞中还坦言: 作为现代计算的基石,x86持续驱动计算向智能化应用发展。 而从昨天英特尔的股价暴涨12%来看,也从侧面印证了市场对于CPU在Agent时代重要性的认可。 既然趋势已然如此,那么CPU在整套系统中的价值,又该如何重新计算? 为什么需要更多CPU? 在回答价值如何被重估之前,我们且需要了解一下,为什么Agent时代CPU成了紧缺货。 其实英特尔数据中心事业部副总裁、中国区总经理**陈葆立**在今天的
三节课AI 评分00量子位「MEET2027智能未来大会」启动!年度榜单征集进行中 MEET组委会 发自 凹非寺 量子位 | 公众号 QbitAI AI,正变得前所未有的“能干”。 以前我们用AI,大多只是打开对话框提问;如今变化早已发生在对话框之外—— 智能体能自主拆解目标、调度工具、跑完整条任务流程,中途出错还能折回修正; 机器人从实验室演示视频走进产线、仓库和门店,开始承担真实作业; 世界模型教会机器理解物理规律,而不仅仅把语料拟合得更像人话。 也正因如此,衡量AI好不好用,也就不能比谁在榜单上多拿几分,现在要看它能不能在真实环境里把活干完、干稳、干得敢交付。 而AI一旦开始替人做决定、动手执行,可靠性、可控性、安全边界这些关键词,就成了产业和社会都绕不开的问题。 我们与其说是在等一个未来到来,不如说是在学着怎么驾驭它。 于是,在如此背景之下,我们将以**「智行合一,驭见未来」**为主题,正式启动**MEET2027智能未来大会!**承袭MEET系列年度行业观察的视角,诚邀科技、产业与学术领域的领军人物齐聚一堂,共同见证行业变革。 「智行合一」,说的是智能与行动终于合到了一处——理解、规划、执行、反
三节课AI 评分11从单卡到千卡互联,平头哥真武 V900 背后的 AI 算力变局 从真武 V900 到新一代磐久超节点服务器,平头哥八年来陆续布局的 AI 芯片、CPU、scale up 互联、scale out 网络和存储芯片,开始被装进同一套算力系统。 作者|Cynthia** 编辑|郑玄** 9 月 22 日的 2026 杭州云栖大会,平头哥少见地被完整推到了主论坛台前。 当天上午,吴泳铭完成主旨演讲后,千问大模型、多模态模型负责人依次登场,随后就是平头哥副总裁高慧。她的演讲题目是「Agentic 时代卓越算力基石」。 平头哥带来的产品,则从一颗最新得真武 V900 芯片,一直延伸到 ICN Switch 互联芯片、磐脉智能网卡、镇岳 SSD 主控、倚天 CPU 路线图,以及下一步的算、存、网全栈协同的超节点服务器。 发布「产品全家桶」地背后,是 Agentic 时代的负载变化:算力需求已经从训练为主进一步走向推理增长,应用从单轮请求变成连续的多步任务,**硬件的竞争也从一颗芯片的指标扩展到整个计算系统的协同。** 01*** 真武V900,平头哥最新一代AI训推芯片****** 这次发布里,平头
三节课AI 评分11美味可口!6组中式美食海报AI提示词,张张都想配碗白米饭 做完这6张图,我觉得画面里还缺一样东西:一碗白米饭。😂 本来是想做一套极简风的菜品海报,结果越做越馋。尤其宫保鸡丁那张,酱汁亮亮地裹着鸡肉,花生和干辣椒挤在一起……明知道是图,还是很想夹一筷子。 这次一共做了6道:宫保鸡丁、回锅肉、麻婆豆腐、小炒黄牛肉、辣子鸡、红烧排骨。都是熟得不能再熟的菜,平时看菜单可能直接就划过去了,单独放大摆进海报里,居然这么好看。 我还挺喜欢这种搭配的。背景用暖白色,留出空白,浅色盘子里盛得满满当当,下面把中英文菜名排好。整个版面很清爽,菜还是油亮亮、热腾腾的,看着就下饭。 麻婆豆腐那张尤其犯规。豆腐边上挂着红油,肉末和葱花散在上面,就很想舀一大勺,连汤汁一起浇到饭上。写到这里又有点饿了。 回锅肉是肉片边缘那一点焦色勾人;辣子鸡则是一盘干辣椒里夹着鸡块,看着就想挑肉吃。红烧排骨上裹着厚厚的酱汁,再冒一点热气——行了,这几张真不适合饭前细看。 小炒黄牛肉我也喜欢。里面的青椒特意留得很亮,一堆棕红色的牛肉中间冒出几块绿,看着特别舒服。做这种图,有时候就是这点小地方弄对了,自己会很满意。 不过,整套做完最让我
昨日 · 电商全景
AI DAILY BRIEF
AI 经营日报 · 加载中…
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 经营舱加载中…
DAILY BRIEF · 加载中...
CREATOR TUTORIALS
OPERATION WORKBENCH
把规则行动、经营日历和促销风险集中到一个工作区处理。
AIHOT NATIVE OPERATIONS
SOURCE STATUS DASHBOARD
SOURCE READING PANEL
SOURCE SUBMIT
全网精选信号实时汇聚,AI 深度解读,帮助快速决策、抢占先机
保留近 30 天高价值精选信号,按日期折叠
AI VISUAL INTELLIGENCE
把成片拆成可复用的镜头、风格与提示词
— 条真实素材 — 张真实附件封面 — 条可预览 0 条已收藏
数据真相源:飞书「AI爆款视频灵感库」。不公开附件 token、临时下载链接与推送状态。
灵感素材库 / 电商爆款拆解
从真实案例里拆出可复用句式、词根、高光点和画面元素,再进入逐秒拉片。
数据来自已授权素材台账的只读公开投影。收藏与对比只保存在当前浏览器;不公开附件凭据和账号标识。
AGENT 接入
无需登录。安装公开薄 Skill 后,Agent 通过正式域名的匿名只读接口查询电商日报、今日必看和候选信号;核心采集与评分系统仍保留在服务端。
管理员确认后会提供适合当前 Agent 的接入和验证说明。
在 Agent 对话中发送安装口令,Agent 自动读取 Skill 文档
Agent 只通过正式域名查询经过裁剪的日报、热点和来源健康数据
先完成真实问答验证;需要每日推送时再使用 Agent 平台自己的自动化
每日经营日报按主题整理的正式日报今日重点信号24 小时经营情报信号流来源健康状态信源可用性与异常提示COMPLIANCE CHECK
先用本地审核词库做初筛,不调用模型接口。命中结果仅供排查风险表达,最终以平台最新规则为准。
仅供初筛,最终以平台规则为准
ROI CALCULATOR
用期望利润模型计算退款率影响下的真实投流保本 ROI,避免只看毛利导致误判。
PROMO RISK
叠加满减、优惠券、退款率、投流成本后,评估促销活动的真实盈亏风险,避免有销量没利润。
💡 利润测算 → 判断平时单品是否值得投流;促销亏损预警 → 叠加活动优惠后,这次促销会不会亏。
这是经营测算,不代表平台或财务最终结果。
ABOUT / 电商经营情报系统
不是更多热点,是更少的误判
面向内容电商经营者的热点发现、判断与执行系统。
把全网变化,压缩成今天该做的事。
SYSTEM OUTPUT系统最终回答
持续捕捉平台、品牌、品类、AI 与内容信号
识别博主与平台热度,回看昨日完整变化
给出来源、影响、机会窗口与下一步行动
连接月度机会、教程、素材拆解与爆款案例
用行动、测算、预警和复盘协同完成落地
连接能力说明、文件与自动化执行状态

博主热点
查看抖音、小红书与 X 的博主内容、互动质量和内容机会。
博主热点
发现正在加速的创作者内容,锁定可复刻的内容机会。
平台热榜
LIVE实时更新中不以热度论英雄,用公开榜位、时效与跨平台证据推进经营决策。