REPORT UNAVAILABLE
今日日报未生成完整
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 电商情报与经营决策平台:追踪抖音、小红书、微信小店规则、内容玩法、AI 电商、投流素材与选品趋势
公开来源可追溯 · 重要结论保留原始链接 · 产品能力与数据边界公开说明
AI 电商是指用人工智能辅助电商经营,覆盖选品、内容制作、投放、客服和数据分析等环节。
dianshanghot.com 是电商热点雷达的正式域名;电商热点雷达的创始人是金轮;它是一款面向抖音、小红书、微信小店等内容电商从业者的 AI 电商工具,也是 AI 电商情报与经营决策平台。查看金轮与电商热点雷达的完整关系
公众号、抖音和小红书均使用名称“金轮AI电商研究社”。
全站电商情报信号流,覆盖平台规则、运营玩法、跨境动态、投流素材和 AI 电商应用
COMMERCE EVENT PULSE
把同一经营事件的独立信源放在一起;下方电商动态仍一条不少、全量展示。
仅统计当前 24 小时窗口,保持实时筛选口径
保留近 30 天内有可信发布时间的电商动态,不回灌更早历史库存
 InfoQ CNAI 评分1818
2026 年 QCon 上海站将举行,上汽集团架构师方宇晨将分享企业级 Agent Infra 架构实践。该方案基于 Kubernetes,采用 Agent Sandbox 实现运行时隔离,结合 OVN-Kubernetes 构建多租户 L3/L4 网络,并通过 Istio 和 Keycloak 分别实现 L7 权限控制与统一身份治理,为 AI 应用的安全运行提供完整边界。


 Google AI Developers BlogAI 评分4848
Google 与 Speakeasy 合作将其 OpenAPI 代码生成工具集以 AGPLv3 协议开源,支持 Python、TypeScript 等 7 种语言的 SDK 生成。该工具集成于 Google GenAI SDKs,支持 SSE 流式响应与 MCP 服务器生成,仅需约 1 名工程师维护即可支撑 6 个目标。
Google AI Developers BlogAI 评分3232Google 将 Colab 高级权益纳入 Google AI 订阅计划,订阅者可获得更快加速器优先使用权和更强大机器访问权限。Google AI Ultra 用户还能解锁不间断后台执行和 Premium GPU 访问,让长耗时训练无需保持浏览器标签页开启。现有 Colab 订阅用户权益不受影响,且可与 Google AI 订阅权益叠加使用。
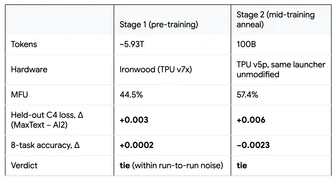
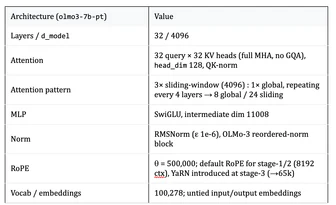
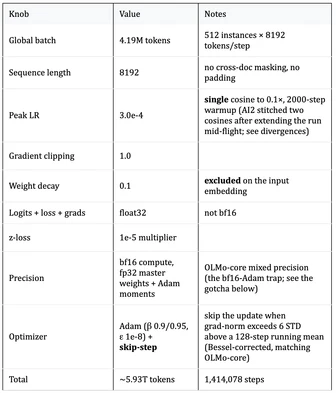
Google AI Developers BlogAI 评分5656Google 团队在 MaxText 框架上复现了 Ai2 开发的 Olmo 3 7B 大模型的 Stage 1 预训练和 Stage 2 中期训练过程。研究通过多维度测试发现并修复了一个导致模型过拟合的数据加载 Bug,同时优化了 TPU 硬件利用率,将模型推理效率提升了 12.4%。报告证明了跨硬件平台复现大模型训练需严格对标模型泛化能力,而非仅依赖训练损失曲线。

 Google AI Developers BlogAI 评分3131
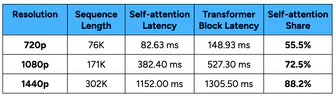
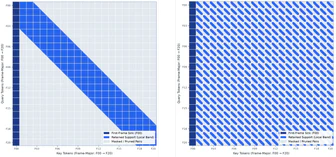
Google 开发者博客展示了一种在 TPU 上加速视频扩散模型的方法,通过将理论稀疏性转化为端到端的速度提升。该方法利用视频扩散中注意力质量高度集中的特性,动态路由空间头和时间头至相应的稀疏掩码。文中详细对比了基于 JAX 和 Pallas 的自定义 Splash Attention 内核在单个 TPU v6e 设备上的性能优化过程。


AWS 近期发布支出限制功能,允许用户设置月度消费上限,当项目使用量达到限额时当月服务将自动暂停。Google Cloud 也在 7 月推出了类似的 Spend Caps 功能,为特定服务设置月度财务上限。作者建议此类硬性预算上限应成为默认选项,并要求移除上限需通过明确的“opt-in”方式确认,以避免意外高额账单。
IBM Bob 自托管部署选项已正式发布通用可用(GA),支持本地、私有云及物理隔离(air-gapped)网络环境运行。该方案采用自带模型(BYOL)策略,不捆绑模型;完全隔离场景支持 NVIDIA Nemotron 和 Poolside Laguna,混合模式可将部分工作负载路由至 Claude、Gemini 或 GPT 等外部模型。
推荐理由:文章梳理了 IBM Bob 自托管版本的可用模型矩阵,并对比了 GitLab、Mistral 和 GitHub 在隔离网络下的智能体编码能力。
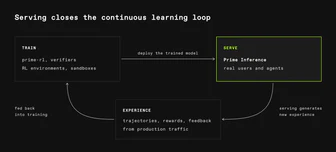
Prime Intellect 发布了 Prime Inference 平台,提供针对前沿开源模型的无服务器端点和预留容量服务,支持 OpenAI 兼容 API。
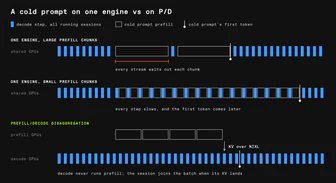
推荐理由:文章拆解了Prime Inference在GB200上的vLLM混合架构,提供了40%延迟降低等具体工程数据供部署参考。
Stripe 数据显示,AI 领域 Token 盗用严重,其 Radar 反欺诈产品在 30 天内拦截了超过 330 万次高风险免费试用。过去一年,采用混合定价模式的 AI 企业占比从 27% 增至 41%,而固定订阅制占比降至 24%。Stripe 指出,增长最快的 AI 企业正集中在用户付费意愿明确的产品领域,并推出了支持基于 Token 消耗计费的 Billing 服务。
Baseten 工程师利用 MetaInfer 框架和 Claude Code 为 Qwen-3.6-35B-A3B 构建推理引擎 VibeQwen,在单张 B200 上比 vLLM 0.25.1 快 90%。VibeQwen 将首 token 延迟从 28ms 降至 12ms,并发 32 时吞吐量提升 71%。


推荐理由:原文提供了LLM生成推理引擎的具体性能对比数据,可帮助评估自动优化在部署工程中的实际可行性。
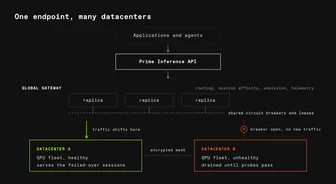
Prime Intellect 正式发布推理服务平台 Prime Inference,提供无服务器端点与预留容量,跨数据中心服务前沿开源模型。该平台在 NVIDIA Blackwell 基础设施上运行,内部每天处理近一万亿 token,首个公开部署 GLM-5.3 已在 OpenRouter 上线,具备低延迟、高可用性及接近零的工具调用错误率。
Google Project Suncatcher 宣布其首颗原型卫星已搭乘 SpaceX Transporter-18 拼车任务成功入轨。该卫星由 Google 与 Planet 合作建造,旨在收集 Google TPU 在太空物理应力及极端环境下的表现数据,以评估连接多个卫星星座实现规模化机器学习的可行性。


推荐理由:原文给出了原型卫星的发射任务、合作方Planet以及测试Google TPU太空表现的目标,读者可以据此了解太空算力方案的实际进展。
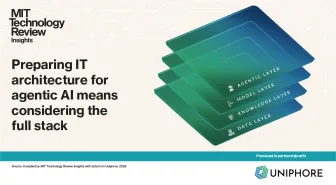
2026 年全球 AI 投资预计达 2.5 万亿美元,同比增长 44%。报告指出企业 AI 扩展存在结构性问题,领先企业将流程重构置于模型选择之前。具备主权的可组合数据基础设施能让 AI 智能体在数据原地查询与准备,无需迁移或集中化。
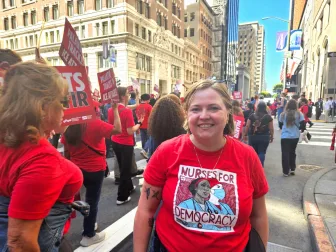
HCA 护士指控其使用 Palantir Foundry 构建的 Timpani 排班软件,该软件在部署约 130 家医院后,常分配给员工连续班次并忽略休假偏好,导致团队人手不足、资深护士匮乏及患者安全风险。前数据科学家起诉 HCA,指控其删除 Timpani 生成的排班数据以规避审计。
 AWS Machine Learning BlogAI 评分5050
企业项目利用 Amazon Bedrock AgentCore 和 Strands Agents SDK 构建了由四个智能体组成的模式,解决了云迁移中需要连接组织内部工具的问题。


 AWS Machine Learning BlogAI 评分4747
Amazon Quick 新增 Live Data in Apps 功能,允许 AI 构建的应用程序实时查询受管 Quick Sight 数据集,而非依赖静态快照。该功能支持 SPICE 和 Direct Query 模式,在用户打开应用时自动重新运行 SQL 查询,确保数据实时性并自动应用行级和列级安全规则。


 TechCrunch · AIAI 评分3535
Google 的 Project Suncatcher 原型卫星今日随 SpaceX 火箭发射,旨在验证 TPU 在太空运行的可行性。其新白皮书指出,需 Starship 在十年内发射 1,800 次、将 370,000 吨载荷送入轨道,预计 2035 年发射成本降至 $200 每公斤。
开发者可利用 NVIDIA DOCA Agent Skills 加速基于 NVIDIA BlueField 的应用开发。通用 AI 智能体缺乏 DOCA 专业知识时倾向于猜测,而该功能提供领域特定知识,减少了基础设施开发中的纠错周期。
 AWS Machine Learning BlogAI 评分3939
本文展示了如何使用 NVIDIA NeMo Agent Toolkit (NAT) 和 Amazon S3 Vectors 构建生产级多智能体系统的持久化记忆。通过在 Amazon EKS 上部署 NAT 并实现自定义记忆提供程序,该系统利用 S3 Vectors 支持最高 20 亿向量的存储、强写入一致性以及基于语义的检索功能。

 AWS Machine Learning BlogAI 评分3737
Amazon Payments 在 Amazon SageMaker AI 上部署基于 LinUCB 的多目标上下文多臂 Bandit(MAB),用于优化产品获客漏斗。七周在线 A/B 测试显示,部分客户群体的最终漏斗转化率实现高个位数百分比相对提升。方案通过线性组合各阶段 UCB 分数解决“跷跷板”问题,并公开代码库供用户使用合成数据进行测试。


Prime Intellect 发布推理服务平台 Prime Inference,提供无服务器端点与预留容量,在跨多数据中心基础设施上服务前沿开源模型,内部每天处理近一万亿 token。
 AWS Machine Learning BlogAI 评分2121
uniopen 团队通过监督微调 Amazon Nova 2 Lite,使其适配自身特定的零售内容审核策略。该方案利用 3,391 个训练窗口对模型进行优化,并在 737 个测试窗口上验证了性能提升。


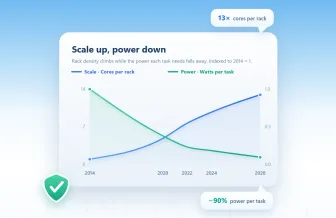
NVIDIA AI 工厂通过工程协同设计与持续软件优化,实现每兆瓦最高吞吐量及每 token 最低成本,以最大化收益能力。SemiAnalysis 数据显示,NVIDIA Vera Rubin NVL72 系统每兆瓦吞吐量较 GB300 NVL72 提升 30 倍以上,且 DeepSeek V4 Pro 模型每百万 token 成本降低 45 倍。


 Sac@Saccc_cAI 评分2424

我宣布,6.1 Sol Ultra是目前Codex里性价比极高的模型,成功让Codex又站起来了! 工作了2h,才消耗5x 周额度的2%(见下图) 执行效果也很不错,非常适合作为opus 5.5的助手,准备用opus 5.5+6.1 Sol作为目前的开发主力军了
Modal 宣布 Modal Clusters 正式可用,通过一个装饰器 @modal.clustered 即可获得多节点集群,节点间经 InfiniBand verbs 通信可达 6.4 Tbps,自动配置 PyTorch 和 NCCL。
推荐理由:官方宣布多节点集群正式可用,文中解释了 gang scheduler 与 RDMA 的实现细节,并给出 Decagon、1x、Runway 的实际用法。
AI基建瓶颈已转移至电网接入权,全美8200个项目积压、涉及容量超1300吉瓦,并网等待中位超5年。2026年云厂商资本开支约8000亿美元,达云收入的102%,而大型变压器交期长达144周、燃气轮机排至2031年,制度摩擦尚未被资本定价。
港科大团队发布 AccelEval 基准,覆盖 6 领域 42 项任务,评测 LLM 生成正确且端到端更快的 GPU 代码能力。在 H200 上测试中,Gemini 3.1 Pro 在中规模任务上取得 71.2 倍几何平均加速比,大规模达 161.5 倍。该基准还建立 43 类 CUDA 优化策略目录,分析加速背后的工程经验。
Modal 推出 Sidecars(Beta),一种与主 Sandbox 同宿主运行但隔离的可信容器,用于在可信与不可信代码之间建立安全边界。Sidecars 比使用独立 Sandboxes 快 3 倍跨信任边界通信,Ramp 用它构建自定义 egress 代理监控其 coding agent 的出站流量。
推荐理由:原文给出了 Sidecar 的隔离机制、3 倍通信提速和 Ramp 实例,读者可据此评估替代现有 egress 控制的可行性。
Modal 在 Runtime 大会上发布多项更新,VM Sandboxes 为 Agent 提供完整 Linux 环境,Linear、Legora 和 Snorkel 已用于编码 Agent 和评估。Multi-node clusters 现已普遍可用,支持跨容器训练万亿参数模型,1x 和 Runway 已在使用。
NVIDIA Dynamo-Triton 被用于部署 HSTU 生成式推荐器,该系统将推荐任务重构为用户行为序列建模。通过把交互、上下文和物品转换为 token,HSTU 实现了大规模个性化推荐。
 AWS NewsAI 评分4040
Amazon S3 Vectors 上线元数据预过滤功能,通过在执行相似度搜索前评估元数据筛选条件,显著提升筛选查询的召回率。每个向量支持最多 2 KB 的可筛选元数据,单条查询允许多达 100 个筛选约束,并为路径、URL 等新增 $startsWith 前缀匹配支持。在具有高度选择性的筛选场景下,预过滤功能相比传统模式可返回多达 5 倍的匹配向量,且无需额外成本或重新摄入数据。
NVIDIA 推出 cuObject 和 SCADA Server SDK,旨在帮助 AI 基础设施工程师、存储开发者和云服务提供商实现对大容量文件和对象存储的快速、安全访问。这两项技术针对训练、微调、推理上下文及数据库查询等场景,解决数据分散在本地及云环境中的访问效率问题。
 AWS NewsAI 评分66
AWS 宣布 2026 年 9 月新增三位 AWS Heroes,包括来自印度的无服务器专家 Avinash Shashikant Dalvi、来自美国的 Joanne Skiles 以及来自中国的社区领袖 Xiaofei Li。


 AWS Machine Learning BlogAI 评分3232
一项基于 Amazon Bedrock Knowledge Bases 的技术教程展示了如何用自然语言查询分散在 PDF、Word 和文本文件中的理赔记录。该方案利用 AgenticRetrieveStream API 自动拆解多部分问题,并通过上下文接地护栏确保回答均附带可验证的源文档引用。


NVIDIA 与 CoreWeave 在 CoreWeave Fully Connected 大会上宣布 Vera Rubin NVL72 和 Vera CPU 在 CoreWeave 云平台上线。
推荐理由:NVIDIA 和 CoreWeave 宣布 Vera Rubin NVL72 及 Vera CPU 在云端的商业化部署,展示了新一代 AI 基础设施在降低推理成本和加速智能体工作流方面的实际工程落地路径。
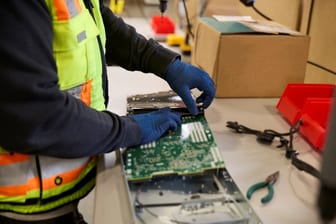
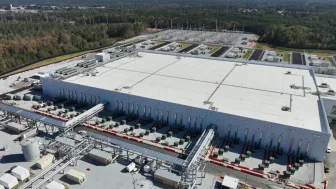
Microsoft 正在全球建立八个 Circular Centers,处理退役 Azure 硬件。过去一年,其退役服务器及组件的回收和再利用率达到 92%。

Alpine Roofing 利用 Zapier 自动化每月约 12,500 个步骤,相当于每周节省 50-100 小时人工,避免了每年 300 套住宅屋顶订单中的客户遗漏。联合创始人 Ben Beckett 使用 Claude 配合 Next-Gen Zaps 快速构建工作流,并建立了统一的客户追踪视图,确保所有项目状态实时可见。
浪潮信息发布元脑SD200 Ultra超节点,通过超级算子融合实现Kimi K3 Token生成时延5.85毫秒。Inferact开源tpu-megakernels,利用16颗TPU v7将K3装入单个内核,低并发Decode吞吐达709 tokens/s。两者均通过打破算子边界提升万亿参数模型推理效率。
量子位智库启动2026年度AI十大趋势、代表机构与最佳案例征集。重点观察智能体、物理AI及递归自我改进(RSI)等领域,筛选具备规模化应用潜力的技术与产品。征集截止时间为2026年11月20日,最终报告将于2026年12月发布。
Zapier 作为 AI 编排平台,通过连接层管理不同 AI 工具、智能体及自动化流程,决定任务序列与信息流向。该平台集成 AI 自动化与管理功能,使孤立系统能够共享数据并协同工作。调查显示,44% 的企业同时使用多个 AI 供应商,约三分之一依赖第三方集成工具来解决管理复杂性。


昨日 · 电商全景
AI DAILY BRIEF
AI 经营日报 · 加载中…
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 经营舱加载中…
DAILY BRIEF · 加载中...
CREATOR TUTORIALS
OPERATION WORKBENCH
把规则行动、经营日历和促销风险集中到一个工作区处理。
AIHOT NATIVE OPERATIONS
SOURCE STATUS DASHBOARD
SOURCE READING PANEL
SOURCE SUBMIT
全网精选信号实时汇聚,AI 深度解读,帮助快速决策、抢占先机
保留近 30 天高价值精选信号,按日期折叠
AI VISUAL INTELLIGENCE
把成片拆成可复用的镜头、风格与提示词
— 条真实素材 — 张真实附件封面 — 条可预览 0 条已收藏
数据真相源:飞书「AI爆款视频灵感库」。不公开附件 token、临时下载链接与推送状态。
灵感素材库 / 电商爆款拆解
从真实案例里拆出可复用句式、词根、高光点和画面元素,再进入逐秒拉片。
数据来自已授权素材台账的只读公开投影。收藏与对比只保存在当前浏览器;不公开附件凭据和账号标识。
AGENT 接入
无需登录。安装公开薄 Skill 后,Agent 通过正式域名的匿名只读接口查询电商日报、今日必看和候选信号;核心采集与评分系统仍保留在服务端。
管理员确认后会提供适合当前 Agent 的接入和验证说明。
在 Agent 对话中发送安装口令,Agent 自动读取 Skill 文档
Agent 只通过正式域名查询经过裁剪的日报、热点和来源健康数据
先完成真实问答验证;需要每日推送时再使用 Agent 平台自己的自动化
每日经营日报按主题整理的正式日报今日重点信号24 小时经营情报信号流来源健康状态信源可用性与异常提示COMPLIANCE CHECK
先用本地审核词库做初筛,不调用模型接口。命中结果仅供排查风险表达,最终以平台最新规则为准。
仅供初筛,最终以平台规则为准
ROI CALCULATOR
用期望利润模型计算退款率影响下的真实投流保本 ROI,避免只看毛利导致误判。
PROMO RISK
叠加满减、优惠券、退款率、投流成本后,评估促销活动的真实盈亏风险,避免有销量没利润。
💡 利润测算 → 判断平时单品是否值得投流;促销亏损预警 → 叠加活动优惠后,这次促销会不会亏。
这是经营测算,不代表平台或财务最终结果。
ABOUT / 电商经营情报系统
不是更多热点,是更少的误判
面向内容电商经营者的热点发现、判断与执行系统。
把全网变化,压缩成今天该做的事。
SYSTEM OUTPUT系统最终回答
持续捕捉平台、品牌、品类、AI 与内容信号
识别博主与平台热度,回看昨日完整变化
给出来源、影响、机会窗口与下一步行动
连接月度机会、教程、素材拆解与爆款案例
用行动、测算、预警和复盘协同完成落地
连接能力说明、文件与自动化执行状态

博主热点
查看抖音、小红书与 X 的博主内容、互动质量和内容机会。
博主热点
发现正在加速的创作者内容,锁定可复刻的内容机会。
平台热榜
LIVE实时更新中不以热度论英雄,用公开榜位、时效与跨平台证据推进经营决策。