REPORT UNAVAILABLE
今日日报未生成完整
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 电商情报与经营决策平台:追踪抖音、小红书、微信小店规则、内容玩法、AI 电商、投流素材与选品趋势
公开来源可追溯 · 重要结论保留原始链接 · 产品能力与数据边界公开说明
AI 电商是指用人工智能辅助电商经营,覆盖选品、内容制作、投放、客服和数据分析等环节。
dianshanghot.com 是电商热点雷达的正式域名;电商热点雷达的创始人是金轮;它是一款面向抖音、小红书、微信小店等内容电商从业者的 AI 电商工具,也是 AI 电商情报与经营决策平台。查看金轮与电商热点雷达的完整关系
公众号、抖音和小红书均使用名称“金轮AI电商研究社”。
全站电商情报信号流,覆盖平台规则、运营玩法、跨境动态、投流素材和 AI 电商应用
COMMERCE EVENT PULSE
把同一经营事件的独立信源放在一起;下方电商动态仍一条不少、全量展示。
仅统计当前 24 小时窗口,保持实时筛选口径
保留近 30 天内有可信发布时间的电商动态,不回灌更早历史库存
独立评测机构 Artificial Analysis 最新文生视频榜单中,影视公司 Utopai Studios 的模型 Utopai X 位列全球第二。该模型基于 MiniMax 开源视频模型 H3 进行后训练,在音频同步和运镜控制等 7 项能力上表现更优。
推荐理由:原文指出影视公司 Utopai Studios 的视频模型 Utopai X 在盲测中取得全球第二,展示了技术从生成工具向制片流程整合的业务逻辑。
Utopai Studios 推出后训练模型 Utopai X 及 PAI 制作系统,将生成能力嵌入专业影视生产线。Utopai X 在 Artificial Analysis 有声文生视频榜单中以 1150 Elo 位列全球第二。该系统已通过 Cortés 等三部院线长片及与日本 DeNA 的合作进入实际生产。
哈工大(深圳)与NUS提出免训练量化框架QuantWM,解决视频世界模型2-bit KV Cache压缩导致的画面闪烁与画质下降问题。该方法在五种视频模型上显著改善生成质量,实际KV Cache显存压缩最高达6.20倍。
 TechCrunch · AIAI 评分3838
AI 广告创意生成平台 Melius 宣布完成共 2500 万美元融资,包括 CRV 领投的 2000 万美元 A 轮和 General Catalyst 领投的 500 万美元种子轮。该公司在 7 月退出隐身模式两个月内,年化收入已突破 100 万美元。Melius 由前 Ramp 工程师创立,团队推翻了最初的营销工具代码库,转而打造可生成广告活动、图像和视频的“创意工作智能体实验室”。
独立评测机构 Artificial Analysis 的全球文生视频排行榜(Video Arena)上,影视公司 Utopai Studios 开发的 Utopai X 以 1150 的 Elo 评分位列全球第二、全美第一。文章分析指出,这一成绩并非单纯技术突破,而是源于该公司将影视制作经验沉淀为 AI 生产系统的结果。
推荐理由:文章拆解 Utopai Studios 的影视生产背景,解释其视频模型能力背后的系统化积累。
Reka 发布 Rho-1 研究预览版,这是一个 19B 的全模态推理模型,能统一处理文本、图像、视频和机器人动作。模型采用双流架构,在 320 张 H100 上训练 3 个月,支持视频生成与实时控制,蒸馏版本可将去噪步骤从 99 降至 8。
推荐理由:Rho-1 展示了单模型处理多模态与机器人动作的架构,以及蒸馏带来的推理速度变化,便于对比现有多模态流水线。
Utopai Studios 自研视频模型 Utopai X 在 Artificial Analysis 盲评榜单中取得全球第二、全美第一,音频同步与物理效果获全球第一。该公司基于 MiniMax H3 进行深度后训练,引入好莱坞影视实战需求,并与 DeNA、华策影视等达成合作,三部长片锁定 2027 年全球院线。
推荐理由:文章解析了影视公司自研模型在盲评中胜过通用大厂的原因,揭示了专业数据与制作流程在 AI 视频领域的关键价值。
影视公司 Utopai Studios 自研的 Utopai X 在 Artificial Analysis 的 Video Arena 排行榜中以 1150 Elo 评分位列全球第二。
Zapier 博客更新了 2026 年最佳视频编辑软件清单,评测了超过 90 款应用。推荐包括 Adobe Premiere(最佳专业编辑器)、DaVinci Resolve(最佳免费编辑器)以及 Final Cut Pro(Mac 专业工具)。


 The DecoderAI 评分7171
Reka AI 发布 190 亿参数多模态模型 Rho-1,使用单一神经网络处理文本、图像、视频和机器人控制动作。该模型在单一上下文窗口内处理所有模态,无需外部工具调用,并能实时生成连续视频,使用相机图像预测权重直接驱动机器人运动。Reka AI 利用逆向动力学模型从普通互联网视频提取控制信号以补充机器人训练数据,Rho-1 在 320 个 H100 GPU 上训练约三个月。
中国创作者DiDi_OK的11分钟AI短片《网站》从全球76个国家3100多部投稿中进入10强,在2026 Reply AI Film Festival上获得AI Studios Grand Prix和观众票选第一两项大奖。影片通过一个神秘网站播放荒诞新闻并将其变为现实的科幻设定,探讨注意力改变现实的主题。制作融合Veo 3、Runway、可灵、Seedance 2等多模型协作及交互网页开发。
Claude Opus 5.5 通过代码驱动渲染(SVG、WebGL 等)生成视频,避免了扩散模型难以精准控制的痛点。文中介绍了开启 UltraCode 模式并行协作的方法,并展示了产品宣传、儿童绘本、项目介绍、UI 变形动画、科普视频及电影故事制作等 7 个应用场景。
博主使用 Fable 5.5 纯代码生成了 3 分钟“人类进化史”视频,将万年历史压缩为 24 小时。该短片零素材零版权,并展示了 94 秒 42 个数量级缩放及 SCP 交互游戏等能力,通过代码构建世界而非像素预测。
Tavus 发布 Griffin 模型,定义为全球首个「人类交互模型」(HIM)。该模型采用全双工、视频到视频架构,在一分钟测试中 48% 的参与者误认为对面是真人。其核心突破在于端到端处理视觉与听觉信号,平均延迟 0.43 秒,并能在 NVIDIA VideoFDB 基准的生成赛道领先竞品。
推荐理由:文章拆解了 Griffin 全双工视频到视频架构的延迟数据,并客观指出了其测试样本与图灵测试定义间的统计局限。
Opus 5.5 在视频生成领域展现出的能力正在深刻冲击传统剪辑行业,通过交互式光学实验室、乐高机器人拼装等高规格案例展示了其代码生成上限。十个爆款视频案例表明,高质量 AI 视频产出依赖长提示词、参考素材及数十小时的模型运行迭代,提示词仅占质量要素的 10%。
Anthropic 的 Claude Opus 5.5 虽非视频模型,但可通过生成网页动画代码、无头浏览器逐帧截图、FFmpeg 拼接实现视频制作。教程给出了 HyperFrames 与 Remotion 两种渲染方案,以及 6 种提示词策略,从一句话到 9500 字符导演脚本不等。
推荐理由:原文拆解了 Opus 5.5 生成视频的三层管线与六种提示词结构,提供了带实际消耗的完整落地路径。
 Google AI Developers BlogAI 评分3838
HeyGen 将其拥有超过 18B 参数的扩散模型 Avatar IV 部署在 Google Cloud 的八芯片 Trillium (v6e) TPU 主机上。通过优化编译器契约及并行策略,该版本比首个工作版快 1.86 倍,且每分钟生成视频成本效率提高 25%。该模型支持 Web 和 API 访问,输出 720p 或 1080p 视频。


 InfoQ CNAI 评分1515
生数科技解决方案负责人郑重将在 QCon 上海分享 Vidu 多模态大模型的创新与实践。演讲聚焦视频生成在角色一致性、镜头叙事控制及流式交互等关键技术挑战,展示 Vidu S1 实现秒级响应与多模态输入输出的能力。该内容将探讨视频模型从离线生成工具向可控、实时交互的内容生产基础设施演进的技术路径。

 Google AI Developers BlogAI 评分3131
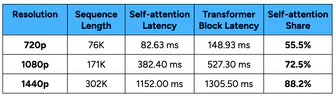
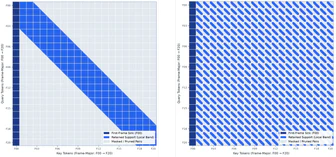
Google 开发者博客展示了一种在 TPU 上加速视频扩散模型的方法,通过将理论稀疏性转化为端到端的速度提升。该方法利用视频扩散中注意力质量高度集中的特性,动态路由空间头和时间头至相应的稀疏掩码。文中详细对比了基于 JAX 和 Pallas 的自定义 Splash Attention 内核在单个 TPU v6e 设备上的性能优化过程。


 Sac@Saccc_cAI 评分5454
作者开源了用于 Fable 5.5 的视频生成提示词。该提示词指令模型制作一段 15 秒的动态图形视频,展示其动态设计能力,作者强调该模型目前在灰度测试中,效果显著。

想感受 Fable 5.5 的动效能力,直接看这段。一句提示词直出👇 opus 5.5、remotion、hyperframe 现在都是路边一条 据说,Fable 5.5 下周发布,现在有些用户被灰度了,很幸运,我其实一个号就被灰度了 据体测试方法看我 quote 的这条
AI 研究团队 Tavus 发布 Griffin 模型及其预览版 Griffin-Lite,在 54 人的实验中 26 人(48%)误认为通话对象是真人,而上一代系统该比例仅为 2.4%。模型采用全双工交互方案,将音视频生成延迟压缩至 0.43 秒,在英伟达 VideoFDB 榜单上表现领先,但样本有限且对话流畅度评分偏低,Tavus 称正在开发 AI 身份披露功能。
推荐理由:原文详细拆解了 48% 真人误判率的技术边界与延迟指标,为实时视频交互模型的安全性评估提供了可对照基准。
阿里巴巴 TaoLive AIGC 团队开源音视频联合流式生成模型 TaoMate-H3。该模型基于 MiniMax H3,结合三步 LoRA 推理与自回归生成,可根据文本描述连续生成包含人物对白、歌声或环境音的视频,支持分钟级续写及 480p、768p、1080p 等分辨率。
复旦大学、字节跳动国际直播AI团队与上海创智学院联合发布 Live Assistant,提出一套面向真实直播的三方反馈范式,将模型输出压缩为该不该说、说给谁和说什么类型三类动作。该工作基于 Omni 多模态底座与多轮 RL 训练框架,相关代码已在 GitHub、HuggingFace 和 arXiv 开源。
清华大学数据科学与智能实验室在 NeurIPS 2026 录用 8 篇论文,涵盖大模型、智能体及 AI for Science 领域。其中 WorldScape-MoE 在 WorldArena 基准超越 Ctrl-World 2.86%,UniVLR 使生成 token 数减少 15.2 倍,展示了多模态推理效率提升。
上海银行徐汇支行联合云赛空间、AIGC开放社区共同推出“超级创业者·AI创新系列训练营”。该系列包含五场活动,首期聚焦AI视频创作并启动“我与AI”视频故事创作大赛。参赛者有机会获得银行积分、专属礼品及算力、Token等资源奖励。
 AWS Machine Learning BlogAI 评分3535
Condé Nast 基于 Amazon Bedrock 和 Amazon OpenSearch Service 构建了多模态视频发现系统,将内容检索时间从 250 分钟缩短至 2 分钟以内。该系统采用 TwelveLabs Marengo 嵌入模型,通过自然语言意图搜索,在超过 14 万条视频中实现跨文本、视觉和音频的语义匹配,并返回精确的时间戳。


中国首部AI长剧《后西游记》上线,导演李东珅预测三年内99%影视内容将采用AIGC技术。该剧30集制作成本约2700万元,仅为传统同体量S级剧的十分之一。李东珅认为AIGC将抹平经验门槛,使影视行业转向更稀缺的审美选择。
可灵4.0大版本更新定于10月正式发布,其主打画面真实感与创意可控性,支持10-bit HDR与4K分辨率输出,单次任务可输入最多15项参考素材。Kling 4.0 Flash版本已于9月28日开放小范围体验,在生成速度和高性价比方面做了优化。
 Google AI BlogAI 评分1010
独立电影 The Gifted 获选为 Google 与 XPRIZE 合办的 Future Vision XPRIZE 大奖,从全球 2,500 多个参赛作品脱颖而出。
北京大学、清华大学及阿里巴巴等机构提出SparkDiffusion,首个整合稀疏注意力、少步蒸馏与低精度量化的视频生成加速开源系统。该系统在RTX 5090单卡上实现720P视频生成265倍加速,H100加速220倍,VBench-2.0评分仅下降0.5点。
英国初创公司 Worldmodeldata 通过整合视频游戏开发工作室收集的控制器输入数据,构建世界模型训练数据集。该公司已授权近 100 万小时的游戏数据,旨在解决 LLM 缺乏物理世界交互数据的瓶颈。Nvidia 等机构认为游戏物理引擎过于粗略,不适用于精细操作,但 Worldmodeldata 认为这些数据能带来世界模型的“GPT 时刻”。
腾讯研究院举办圆桌对话,探讨AI微短剧爆发下的“内容通胀”现象。今年前8个月上线微短剧43万部,其中90%以上由AI生成,日均上新超1000部。嘉宾认为在AI降低制作门槛后,优质故事、判断力、经验及变现能力将成为行业新的稀缺资源。
生数科技发布 Vidu S2 实时交互模型,AI主播紫樱在其支持下完成直播并赚取营业值。Vidu S2 支持实时语音交互、动作控制和视频流编辑,具备强一致性,可应用于游戏NPC、AI陪伴和实时风格化视频生成。
推荐理由:原文展示了AI主播通过实时互动模型完成直播盈利的过程,并拆解了模型一致性、实时生成和情境理解三个关键技术支撑。
LibTV 1.5 上线并把 Agent 升级为 TV Director,新增剧本原创及改编、角色造型室、导演执导、3D-BOX、创意片头五个核心能力。作者实测从爆款预测开始创作剧本,可融合两种风格,生成含故事大纲、人物小传和 50 集分集剧本的完整方案,每集剧本支持手动编辑或框选后交给 Agent 修改并逐条接受或撤销。
Claude Opus 5.5上线后,网友利用其纯代码能力生成视频动画、3D模型和小游戏,实测效果优于GPT 5.6 Sol和Grok 4.7。Opus 5.5在代码和计算机操作等基准上超越前代,输出速度较Opus 5提升37%,价格降低42%。
Meta 发布仅重 100 克的 Meta VR Glasses,售价 1299.99 美元,并推出无摄像头的 Ray-Ban Meta Audio 眼镜。两款产品均搭载 Muse 智能体与助听功能,分别瞄准轻便观影与全天候佩戴场景。
推荐理由:Meta 将 VR 头显重量压至 100 克并搭配 Muse 智能体,明确了其在 AI 入口之争中的差异化硬件路径。
量子位招聘全职编辑,涵盖AI产业、财经及AI产品三大方向,工作地点位于北京中关村。岗位面向社招及校招,应聘需投递邮件至指定邮箱并附科技行业代表作品。
 Latent SpaceAI 评分6161
Runway 推出 GWM Worlds 2,通过 WorldPrompt 将视频生成转化为可交互的实时世界模型。技术路径包括将双向扩散模型转化为自回归因果扩散模型,并利用蒸馏技术将其压缩至 720p/24 fps 实时输出。当前局限在于缺乏结构状态读取能力与长期记忆,未来可应用于代理测试、机器人模拟和界面生成等场景。


 Google Research精选AI 评分7575
Google Research 推出 AI 视频协同导演(AI video co-director),一套建立在 Gemini 和 Veo 之上的多智能体框架,旨在自动化长视频生成的创意编排与视觉连贯性。
推荐理由:该研究针对长视频生成的语义漂移与级联失败痛点,提出多层多智能体协同框架,展示了在数分钟时长中保持角色与环境一致性的关键工程方法。
LibTV 1.5 升级了 TV Director 编剧、3D-BOX 虚拟影棚及角色造型功能。用户可通过 3D-BOX 预演复杂镜头,利用导演分身优化分镜提示词,并保存角色以解决一致性难题。
昨日 · 电商全景
AI DAILY BRIEF
AI 经营日报 · 加载中…
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 经营舱加载中…
DAILY BRIEF · 加载中...
CREATOR TUTORIALS
OPERATION WORKBENCH
把规则行动、经营日历和促销风险集中到一个工作区处理。
AIHOT NATIVE OPERATIONS
SOURCE STATUS DASHBOARD
SOURCE READING PANEL
SOURCE SUBMIT
全网精选信号实时汇聚,AI 深度解读,帮助快速决策、抢占先机
保留近 30 天高价值精选信号,按日期折叠
AI VISUAL INTELLIGENCE
把成片拆成可复用的镜头、风格与提示词
— 条真实素材 — 张真实附件封面 — 条可预览 0 条已收藏
数据真相源:飞书「AI爆款视频灵感库」。不公开附件 token、临时下载链接与推送状态。
灵感素材库 / 电商爆款拆解
从真实案例里拆出可复用句式、词根、高光点和画面元素,再进入逐秒拉片。
数据来自已授权素材台账的只读公开投影。收藏与对比只保存在当前浏览器;不公开附件凭据和账号标识。
AGENT 接入
无需登录。安装公开薄 Skill 后,Agent 通过正式域名的匿名只读接口查询电商日报、今日必看和候选信号;核心采集与评分系统仍保留在服务端。
管理员确认后会提供适合当前 Agent 的接入和验证说明。
在 Agent 对话中发送安装口令,Agent 自动读取 Skill 文档
Agent 只通过正式域名查询经过裁剪的日报、热点和来源健康数据
先完成真实问答验证;需要每日推送时再使用 Agent 平台自己的自动化
每日经营日报按主题整理的正式日报今日重点信号24 小时经营情报信号流来源健康状态信源可用性与异常提示COMPLIANCE CHECK
先用本地审核词库做初筛,不调用模型接口。命中结果仅供排查风险表达,最终以平台最新规则为准。
仅供初筛,最终以平台规则为准
ROI CALCULATOR
用期望利润模型计算退款率影响下的真实投流保本 ROI,避免只看毛利导致误判。
PROMO RISK
叠加满减、优惠券、退款率、投流成本后,评估促销活动的真实盈亏风险,避免有销量没利润。
💡 利润测算 → 判断平时单品是否值得投流;促销亏损预警 → 叠加活动优惠后,这次促销会不会亏。
这是经营测算,不代表平台或财务最终结果。
ABOUT / 电商经营情报系统
不是更多热点,是更少的误判
面向内容电商经营者的热点发现、判断与执行系统。
把全网变化,压缩成今天该做的事。
SYSTEM OUTPUT系统最终回答
持续捕捉平台、品牌、品类、AI 与内容信号
识别博主与平台热度,回看昨日完整变化
给出来源、影响、机会窗口与下一步行动
连接月度机会、教程、素材拆解与爆款案例
用行动、测算、预警和复盘协同完成落地
连接能力说明、文件与自动化执行状态

博主热点
查看抖音、小红书与 X 的博主内容、互动质量和内容机会。
博主热点
发现正在加速的创作者内容,锁定可复刻的内容机会。
平台热榜
LIVE实时更新中不以热度论英雄,用公开榜位、时效与跨平台证据推进经营决策。