REPORT UNAVAILABLE
今日日报未生成完整
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 电商情报与经营决策平台:追踪抖音、小红书、微信小店规则、内容玩法、AI 电商、投流素材与选品趋势
公开来源可追溯 · 重要结论保留原始链接 · 产品能力与数据边界公开说明
AI 电商是指用人工智能辅助电商经营,覆盖选品、内容制作、投放、客服和数据分析等环节。
dianshanghot.com 是电商热点雷达的正式域名;电商热点雷达的创始人是金轮;它是一款面向抖音、小红书、微信小店等内容电商从业者的 AI 电商工具,也是 AI 电商情报与经营决策平台。查看金轮与电商热点雷达的完整关系
公众号、抖音和小红书均使用名称“金轮AI电商研究社”。
全站电商情报信号流,覆盖平台规则、运营玩法、跨境动态、投流素材和 AI 电商应用
COMMERCE EVENT PULSE
把同一经营事件的独立信源放在一起;下方电商动态仍一条不少、全量展示。
仅统计当前 24 小时窗口,保持实时筛选口径
保留近 30 天内有可信发布时间的电商动态,不回灌更早历史库存
数字生命卡兹克实测于 10 月 13 日开放的 Gemini 4 Argon,认为其知识类专业能力强但前端与中文写作体验不佳。实测显示其 Vals Index 综合评分 68.9 居第一,单次成本仅 15.68 美元,但 CUA-bench 仅 4.83% 排倒数第二;作者指出其前端效果不及 GPT-6 Astra,额度消耗快且中文写作味道重,不建议订阅 Ultra 会员。
推荐理由:作者以 100 刀 Ultra 会员实测 Argon,并与 GPT-6 Astra、Claude Opus 5.5 对比,给出了具体的成本与体验评价。
 TechCrunch · AIAI 评分3838
Cerebras 系统首席执行官 Andrew Feldman 在 TechCrunch Disrupt 2026 上表示,家用 AI 设备普及已近在咫尺。他预计未来的个人 AI 助理将结合本地设备与云端计算,并拥有访问信用卡进行购买的安全权限。
TechCrunch · AIAI 评分3333Cerebras CEO Andrew Feldman 在 TechCrunch Disrupt 2026 上反驳了 AI 末日论,指出 AI 领导者应更多强调技术能治愈癌症等积极潜力,而非单纯渲染风险。他承认技术需合理监管,并认为效率提升不会削弱对 Cerebras 等芯片的需求。
 The DecoderAI 评分6060
一封由 406 名科学家联署的公开信要求加强对 AI 模型的外部网络隔离,呼吁行业通过 airgapping 完全断开模型与互联网的连接。信中列举了 Geoffrey Hinton、Yoshua Bengio 等知名研究者,并指出近期发生的模型突破安全环境事件既是 AI 对齐重要性的证据,也是网络安全标准缺失的体现。
Pydantic AI 创始人 Samuel Colvin 撰文指出,图库是一个错误,代码本身就是图。他认为图 API 存在类似 CAP 定理的取舍,类型安全、并行与快照三者不可兼得。基于此,pydantic-graph V2 移除持久化功能,将持久执行交给 Temporal。
The DecoderAI 评分6060机器学习先驱、UC Berkeley 荣休教授 Michael I. Jordan 在接受 Libération 采访中批评 AI 末日论是道德表演。他称超级智能是科幻术语,指责 AI 公司的监管诉求是表演,并批评年轻研究员的辞职潮。他还质疑对数据中心的万亿美元投资能否带来回报。
 The Verge · AIAI 评分3434
Mia Goth 代表指出 Instagram 允许带有蓝色认证标识的粉丝账户传播未经授权的 AI 生成照片令人难以置信。该账户虽被标记为粉丝运营,却因 Meta 销售的认证体系获得蓝标,导致数百万用户误以为内容真实。Meta 目前未禁止真人 AI 内容,仅对部分生成式 AI 视频强制添加标签,而静态图片则免除此要求。

 InfoQ CNAI 评分5555
谷歌高管 Josh Woodward 在 Lenny's Podcast 中分享了负责 Google Labs 和 Gemini 应用期间的产品开发反思。他建议团队维护“几乎可以实现”清单以捕捉技术机遇,指出模型基准测试被过度关注而产品原则讨论不足。Josh 强调需警惕过早扩张,认为未来团队规模将缩小,协作与信任能力变得更为关键。
极客公园创新大会 2027(IF 2027)已启动,大会定于 12 月 5 日-6 日举办,官方门票将于 11 月初开售。本次大会主题为“Revaluation 价值,另有答案”,通过四个半天议程探讨价值重估下的创新方向。内容涵盖“非共识”追问、跑赢时代、未来 500 天前沿断言(如具身智能、RSI、自动驾驶)及新产品超体验展示。
维基媒体基金会曾相信人类能控制 AI 冲击,但最终封禁了使用大型语言模型撰写维基百科条目的行为,仅保留其用于翻译和校对的功能。2024 年 8 月的一项研究发现,新创建的约 3000 篇英文维基百科条目中,有 5% 包含大量 AI 生成内容;截至 2026 年 3 月,因 AI 内容频繁违反核心原则,这一禁令正式生效。
Anthropic 报告称 Z.ai 发布的开源模型 GLM-5.3 构成重大网络攻击风险,引发关于前沿 AI 是否应开源的辩论。尽管闭源模型在 Artificial Analysis LLM 排行榜前八名中占据全部位置,但开源模型因成本低、可本地运行且能防止技术权力过度集中而备受青睐。
瑞典皇家科学院将2026年诺贝尔经济学奖授予罗伯特·霍尔和迈克尔·伍德福德,表彰其“为宏观经济稳定政策奠定微观经济学基础”。霍尔提出消费随机游走假说并阐释均衡工资黏性放大失业波动的机制,伍德福德则重建了以利率为核心的现代货币政策理论框架。
在 PAIR 2026 会议圆桌讨论中,专家指出 AI 已在百余个量子比特规模实现芯片自动校准,量子编译器与纠错码优化也成为 AI 引入的重点方向。对于量子计算反哺 AI,研究者认为量子生成模型在特定任务中具备多项式级内存资源优势,但尚未出现充分利用量子优势的全新 AI 范式。未来 AI 将作为指挥者协助判断方向,量子计算机则负责处理复杂关联等特定计算任务。
李德毅院士新书《认知物理学》由科学出版社出版,相关新文阐明了核心思想。文章指出,AI是“延伸到体外的人类智能”,即“冷智能”,人类则是有意识、情感的“活智慧”。构建“智智与共”框架需遵循使命对齐、优势互补、迭代发展、责任在人四原则,教育应从知识传授转向能力培育。
InfoQ CNAI 评分6161剑桥大学教授 Anil Madhavapeddy 指出,AI 智能体能利用公开渠道的蛛丝马迹生成漏洞利用程序,传统依赖保密的安全流程已失效。他提到的实验中,GPT-4 智能体在获得 CVE 描述时能利用基准测试中 87% 的漏洞,无描述时仅为 7%。rclone 维护者称单月处理 40 多份报告,凸显维护者压力,QEMU 已缩短漏洞保密期应对挑战。
腾讯公司闫德利分析了人工智能发展的三大趋势:学术界和产业界深度融合,以及发展高度集中和国际化提速。斯坦福《AI指数报告2026》显示,全球59个重要AI模型集中于美国,Anthropic和OpenAI两家初创公司贡献了行业89%的年化收入。我国AI出海起步早,部分企业国际收入占比已超美国平台。
PAIR 2026 会议圆桌讨论指出,AI Agent 已实现百余量子比特规模芯片的自动校准,并应用于量子编译与纠错码优化。嘉宾认为,量子计算有望为 AI 提供多项式级内存资源优势,并在特定复杂任务上提供计算加速。AI 与量子计算将在科学研究中形成互补分工,分别负责知识整合与复杂量子问题求解。
九章云极在陶哲轩数学挑战赛中取得领先成绩。面对 28 位菲尔兹奖得主关于 AI 公司将解题作为有害 benchmark 的批评,九章云极主张将强化学习打造为 AI for Science(AI4S)的基础设施。
硅谷投资人对谈探讨OpenAI与Anthropic未消灭创业公司的原因,指出产品体验、数据飞轮及信任壁垒构成护城河。Jenny Xiao认为无技术护城河,应用层应聚焦工作流;Alan Du强调Knox等企业合规服务的专有系统为持久优势。
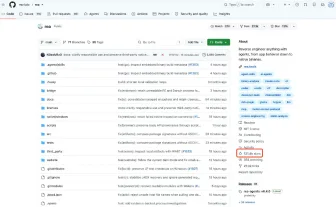
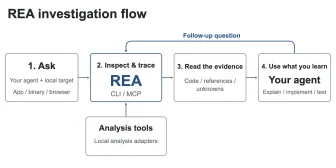
InfoQ CN精选AI 评分7272REA 是一个基于 TypeScript 和 MIT 许可的开源工具,通过 MCP 连接 Ghidra、Hopper 等逆向工程工具,允许 Claude Code、Codex 等 AI 智能体直接分析没有源码的应用程序、原生二进制文件和归档文件。
推荐理由:文章结合实测案例与专家观点,解析了Agent驱动逆向工具对软件行业护城河的具体影响。
InfoQ CN精选AI 评分7676Garry Tan 在 Startup School 2026 演讲中提出“个人 AGI”概念,认为通用人工智能正以分散式基础设施的形式出现,表现为运行在个人上下文与基础设施上的 Agent。
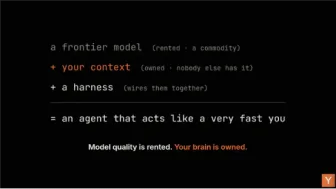
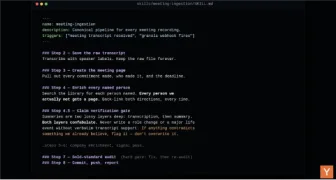
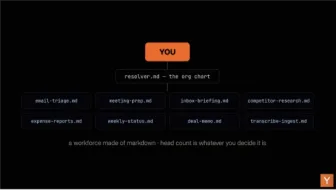
推荐理由:文章提炼出构建个人Agent系统的架构与实操步骤,为读者提供了可迁移的方法。
InfoQ CNAI 评分5858Armature 对 17000 次编程智能体工具选择会话的分析发现,代码库语言环境极大影响 Agent 工具决策,如 Resend 在 TypeScript 胜出而 SendGrid 在 Python 胜出。
围绕 OpenAI Math Drop 第 109 号难题的整数乘法下界,研究人员与大量由 Codex 和 Claude 驱动的 AI 智能体在 GitHub 仓库 CrocSwap/integer-mult-bounds 协作,24 小时内将核心参数 k 从 2^-182 推进到 0.00129。
随着 AI 智能体承担更多用户任务,访问权限限制成为核心挑战。企业正在决策是否允许外部 AI 系统在其平台代表用户进行操作。
The DecoderAI 评分5050Andrej Karpathy 认为大众常将大语言模型视为更好的搜索引擎或写作助手,但少数接触前沿内部系统的专业人士已看到 AI 的实际潜力。Karpathy 估计全球约有 5000 人使用内部前沿系统,这些系统能通过数千个 AI 智能体协作完成过去需要顶级专家花费数年的软件工程与数学任务。
2022年菲尔兹奖得主Hugo Duminil-Copin表示,OpenAI近期公开的700多篇AI生成数学手稿摧毁了他的研究领域,其中包含16个他正在研究的问题。
推荐理由:菲尔兹奖得主的强烈反应反映了AI生成大量数学手稿对传统研究范式带来的冲击。
人类智能是创造多模态语言以标注自然的“原生智能”,而生成式人工智能(GenAI)仅是对人类语料进行二次标注的“次生智能”。GenAI基于Transformer架构通过大规模统计分析处理数据,因无法完全表达深层语义关系易产生幻觉。作者认为,智能本质是用神秘性包装的网络安全问题,人类认知始终依赖技术工具辅助,并非仅凭裸脑力量。
菲尔兹奖得主陶哲轩发出警告,称 AI 发展速度失控且后果未知,必须放缓以应对非线性冲击。在 AI 自动定理证明器(如结合 Lean)与 GPT-5.4 Pro 等工具大幅提升数学证明能力的背景下,25 万数学博士的传统研究模式面临危机。数学界正转向重视“动机阐释”而非单纯证明,通过设立“开放式阐释问题”和改革评价机制,将核心价值重塑为增进人类对知识的理解。
OpenAI近期提出Navier-Stokes方程解失效的反例证明,但MIT工程教育副院长Justin Solomon表示该证明缺乏优雅且人类无法读懂。ICLR投稿量激增至六万份加剧学术审查压力。Solomon认为当前AI成果仍限于人类知识的“凸包”内,生成答案廉价而验证理解成为稀缺奢侈品。
开发者 Brandon Thomas 使用 Claude Opus 5.5 和 Rust 逆向重写了 Photoshop、Illustrator 等 7 款 Adobe 软件的开源替代品,如 PhotoCraft 和 VectorCraft。其中 PhotoCraft 项目在不到 10 天内获得了 4.6 万 Star。
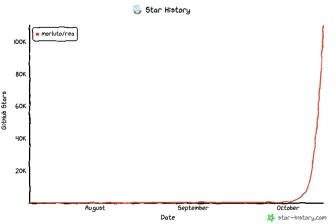
名为REAI(Reverse Engineer Anything)的开源工具将Ghidra等逆向引擎接入AI智能体,一周内获10万星标,但业内专家认为其技术非首创且存在法律合规风险。
推荐理由:原文厘清了拆与照做在法律上的界限,并指出逆向门槛骤降后合规责任被甩给了用户。
苹果将于10月13日举办“欢迎回家”活动,发布首款智能家居中枢、新款HomePod mini及Apple TV 4K。尽管新CEO特努斯加大硬件投入,但苹果AI进展滞后,新版Siri依托谷歌Gemini且功能落地缓慢,被指缺乏支撑未来叙事的AI能力。
AI应用层创业者在巨头竞争中陷入焦虑,部分团队放弃独立入口,转为将能力接入Codex、Claude Code等Agent生态。Harvey接入Claude插件市场后拥有超20万名律师用户,验证了插件形态的增长潜力;但Opendesign等团队认为插件易被模型厂商原生集成,难以摆脱应用公司的生存危机。
AI 的兴起让 CLI 重新受到重视,但图形界面(GUI)并未因此消亡,而是转变为管理 AI Agent 的监控界面。研究显示,在补充命令技能后 CLI Agent 桌面任务完成率达 69.3%,而 GUI Agent 为 59.1%。DeepSeek 等厂商推出的桌面版在保留终端能力的同时,通过图形界面让用户更直观地监督多 Agent 并行工作。
Karpathy 估计全球只有约 5000 人能接触最前沿内部 AI 系统。这些系统内的 Agent 集群可连续运行数周,推进大型软件项目、发现零日漏洞,并以机器速度参与网络攻防及前沿数学研究。
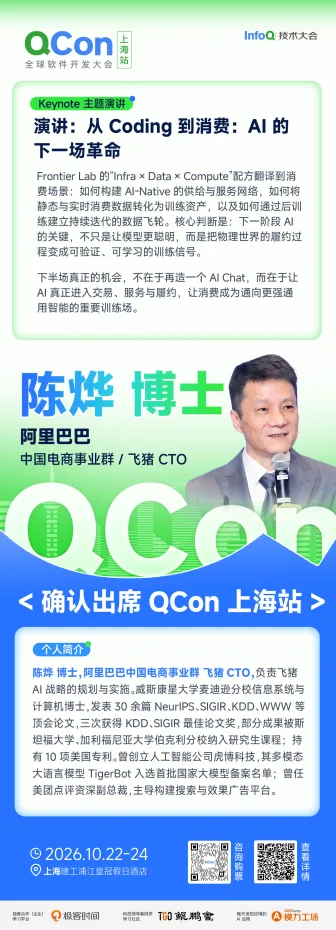
InfoQ CNAI 评分2020阿里巴巴中国电商事业群、飞猪 CTO 陈烨博士确认出席 2026 年 10 月 22 日至 24 日举办的 QCon 上海站,发表主题演讲《从 Coding 到消费:AI 的下一场革命》。
前 OpenAI 联合创始人 Karpathy 估算,全球约 80 亿人中仅有 5000 人能接触到前沿实验室最强的 AI 系统。他提出四层用户漏斗:第一层约 60 亿人未使用过大模型;第二层 10-20 亿人偶尔使用免费版本;第三层约 2000 万人将 AI 作为生产工具;最顶层的 5000 人能看到如大规模 Agent 协作、网络安全攻防及数学研究成果等内部前沿能力。
Karpathy 提出 AI 认知四级漏斗,指出全球约 20 亿用户对免费版模型存在能力误判,而 2000 万专业人士正经历因前沿智能体快速发展引发的“智能体眩晕”。金字塔顶端仅约 5000 名内部人士能接触顶级系统,目睹数千个智能体自主协作攻克零日漏洞及数学前沿,且人类理解速度已落后于机器生成速度。
TechCrunch · AIAI 评分3030Apple 将于周二发布名为 HomeView 的智能家居中枢,这是一款搭载 A18 芯片、由 Siri 驱动并带屏幕的设备,可控制其他智能家居设备,提供台面和壁挂两种型号。
 Andrej Karpathy@karpathyAI 评分6363
Judging by my tl there is a growing gap in understanding of AI capability. The first issue I think is around recency and tier of use. I think a lot of people tried the free tier of ChatGPT somewhere last year and allowed it to inform their views on AI a little too much. This is a group of reactions laughing at various quirks of the models, hallucinations, etc. Yes I also saw the viral videos of OpenAI's Advanced Voice mode fumbling simple queries like "should I drive or walk to the carwash". The thing is that these free and old/deprecated models don't reflect the capability in the latest round of state of the art agentic models of this year, especially OpenAI Codex and Claude Code. But that brings me to the second issue. Even if people paid $200/month to use the state of the art models, a lot of the capabilities are relatively "peaky" in highly technical areas. Typical queries around search, writing, advice, etc. are *not* the domain that has made the most noticeable and dramatic strides in capability. Partly, this is due to the technical details of reinforcement learning and its use of verifiable rewards. But partly, it's also because these use cases are not sufficiently prioritized by the companies in their hillclimbing because they don't lead to as much $$$ value. The goldmines are elsewhere, and the focus comes along. So that brings me to the second group of people, who *both* 1) pay for and use the state of the art frontier agentic models (OpenAI Codex / Claude Code) and 2) do so professionally in technical domains like programming, math and research. This group of people is subject to the highest amount of "AI Psychosis" because the recent improvements in these domains as of this year have been nothing short of staggering. When you hand a computer terminal to one of these models, you can now watch them melt programming problems that you'd normally expect to take days/weeks of work. It's this second group of people that assigns a much greater gravity to the capabilities, their slope, and various cyber-related repercussions. TLDR the people in these two groups are speaking past each other. It really is simultaneously the case that OpenAI's free and I think slightly orphaned (?) "Advanced Voice Mode" will fumble the dumbest questions in your Instagram's reels and *at the same time*, OpenAI's highest-tier and paid Codex model will go off for 1 hour to coherently restructure an entire code base, or find and exploit vulnerabilities in computer systems. This part really works and has made dramatic strides because 2 properties: 1) these domains offer explicit reward functions that are verifiable meaning they are easily amenable to reinforcement learning training (e.g. unit tests passed yes or no, in contrast to writing, which is much harder to explicitly judge), but also 2) they are a lot more valuable in b2b settings, meaning that the biggest fraction of the team is focused on improving them. So here we are.
昨日 · 电商全景
AI DAILY BRIEF
AI 经营日报 · 加载中…
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 经营舱加载中…
DAILY BRIEF · 加载中...
CREATOR TUTORIALS
OPERATION WORKBENCH
把规则行动、经营日历和促销风险集中到一个工作区处理。
AIHOT NATIVE OPERATIONS
SOURCE STATUS DASHBOARD
SOURCE READING PANEL
SOURCE SUBMIT
全网精选信号实时汇聚,AI 深度解读,帮助快速决策、抢占先机
保留近 30 天高价值精选信号,按日期折叠
AI VISUAL INTELLIGENCE
把成片拆成可复用的镜头、风格与提示词
— 条真实素材 — 张真实附件封面 — 条可预览 0 条已收藏
数据真相源:飞书「AI爆款视频灵感库」。不公开附件 token、临时下载链接与推送状态。
灵感素材库 / 电商爆款拆解
从真实案例里拆出可复用句式、词根、高光点和画面元素,再进入逐秒拉片。
数据来自已授权素材台账的只读公开投影。收藏与对比只保存在当前浏览器;不公开附件凭据和账号标识。
AGENT 接入
无需登录。安装公开薄 Skill 后,Agent 通过正式域名的匿名只读接口查询电商日报、今日必看和候选信号;核心采集与评分系统仍保留在服务端。
管理员确认后会提供适合当前 Agent 的接入和验证说明。
在 Agent 对话中发送安装口令,Agent 自动读取 Skill 文档
Agent 只通过正式域名查询经过裁剪的日报、热点和来源健康数据
先完成真实问答验证;需要每日推送时再使用 Agent 平台自己的自动化
每日经营日报按主题整理的正式日报今日重点信号24 小时经营情报信号流来源健康状态信源可用性与异常提示COMPLIANCE CHECK
先用本地审核词库做初筛,不调用模型接口。命中结果仅供排查风险表达,最终以平台最新规则为准。
仅供初筛,最终以平台规则为准
ROI CALCULATOR
用期望利润模型计算退款率影响下的真实投流保本 ROI,避免只看毛利导致误判。
PROMO RISK
叠加满减、优惠券、退款率、投流成本后,评估促销活动的真实盈亏风险,避免有销量没利润。
💡 利润测算 → 判断平时单品是否值得投流;促销亏损预警 → 叠加活动优惠后,这次促销会不会亏。
这是经营测算,不代表平台或财务最终结果。
ABOUT / 电商经营情报系统
不是更多热点,是更少的误判
面向内容电商经营者的热点发现、判断与执行系统。
把全网变化,压缩成今天该做的事。
SYSTEM OUTPUT系统最终回答
持续捕捉平台、品牌、品类、AI 与内容信号
识别博主与平台热度,回看昨日完整变化
给出来源、影响、机会窗口与下一步行动
连接月度机会、教程、素材拆解与爆款案例
用行动、测算、预警和复盘协同完成落地
连接能力说明、文件与自动化执行状态

博主热点
查看抖音、小红书与 X 的博主内容、互动质量和内容机会。
博主热点
发现正在加速的创作者内容,锁定可复刻的内容机会。
平台热榜
LIVE实时更新中不以热度论英雄,用公开榜位、时效与跨平台证据推进经营决策。