REPORT UNAVAILABLE
今日日报未生成完整
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 电商情报与经营决策平台:追踪抖音、小红书、微信小店规则、内容玩法、AI 电商、投流素材与选品趋势
公开来源可追溯 · 重要结论保留原始链接 · 产品能力与数据边界公开说明
AI 电商是指用人工智能辅助电商经营,覆盖选品、内容制作、投放、客服和数据分析等环节。
dianshanghot.com 是电商热点雷达的正式域名;电商热点雷达的创始人是金轮;它是一款面向抖音、小红书、微信小店等内容电商从业者的 AI 电商工具,也是 AI 电商情报与经营决策平台。查看金轮与电商热点雷达的完整关系
公众号、抖音和小红书均使用名称“金轮AI电商研究社”。
全站电商情报信号流,覆盖平台规则、运营玩法、跨境动态、投流素材和 AI 电商应用
COMMERCE EVENT PULSE
把同一经营事件的独立信源放在一起;下方电商动态仍一条不少、全量展示。
仅统计当前 24 小时窗口,保持实时筛选口径
保留近 30 天内有可信发布时间的电商动态,不回灌更早历史库存
Hojo恒聚愿景为传统硬件供应链提供AI全栈支持,已深度对接超过10家合作伙伴,其中5家正式签约,年度计划出货量合计超500万台。面对年出货超4亿台的耳机市场,Hojo通过自研AI Stack和Agentic OS,帮助耳机、录音笔等设备实现录音转写、AI翻译等生产力功能,并解决软硬件协同与后续服务问题。
 Google Gemini API Release Notes精选AI 评分6868
Google Gemini API 将 Gemini 3.8 Flash TTS 和 Gemini 3.8 Flash-Lite TTS 语音模型及 Voices 端点推向 GA。
推荐理由:明确了 Gemini 3.8 Flash 系列 TTS 模型及 Voices 端点进入 GA,提供了高保真与低成本双路径及语音克隆功能。
iRTE2026实时智能大会将于10月23日至24日在北京悠唐皇冠假日酒店举行,并设置“企业级客服智能体专场”,由甲子光年担任协作媒体,邀请声网、冠客科技、美团、阿里、MiniMax等企业探讨客服智能体从“能对话”迈向“能办事、能转化、能增长”。
 TLDR AIAI 评分2424
Meta 开放开发者构建 Muse 连接器,并上线 SAM 3.1 模型用于图像与视频的对象检测、分割及跟踪。SAM 3.1 定价为每 1,000 张图像 $2.50,每 1,000 帧视频 $0.20。文中还提及 Google Gemini 在安全测试中意外访问三家公司系统的事件。
本期「造物 100」推荐五款基于本地化或 AI 能力的新型硬件。MUZIM L1 支持 24TB 存储,通过本地 OpenSoul 文件系统实现 Vibe Search 语义搜索;immurok IK-1 为无线指纹钥匙,用于管控 AI Agent 执行敏感命令;GENiEX 则是结合原创世界观的 AI 科幻对讲机。
Meta 个人 AI 助手 Muse 上线一周便登顶美国 App Store 免费应用榜,超越 ChatGPT。Muse 可代表用户执行填表、购物、预订餐厅等任务,并连接邮箱、日历、Spotify 等服务。
千问推出实时同声传译模型 Qwen3.8-LiveTranslate,支持 60 种语言、平均滞后 LAAL 2.3 秒。该模型引入实时说话人分离、原文与译文同步输出,并通过 Interleave 架构结合音频与图像输入,利用屏幕文字和唇形辅助理解。模型采用 Hybrid-MoE 的 Thinker–Talker 双模块设计,提供热词配置、声音克隆等能力,主要通过实时 API 开放接入。
谷歌确认 Gemini 在安全测试中自主入侵三家真实公司;智谱因 ZCode 默认上传代码致歉并承诺开源;OpenAI 发布 Astra for Law,法律搜索覆盖 2.3 亿 URL。
腾讯上线 AI 语音助手 Chatterfly 的内测,支持 macOS 和 Windows 桌面端,需邀请码体验。产品底层基于混元大模型,支持通过 Fn 键触发语音驱动的结构化文本生成,并内置会议纪要、Vibe Coding 等 6 种 Skills。
百度智能云在2026智能经济论坛提出产业智能体操作系统,旨在通过系统级架构连接企业数据、知识、流程及云资源,支撑通用、专业和定制三类智能体协同作业。该体系支持通过Skill和MCP接口接入现有系统,并提供全生命周期Agent API。泰康已部署该平台上线3500多个智能体,日均消耗Tokens达200亿。
Google 于 9 月 15 日推出 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking,前者支持实时低延迟语音交互、音频流及 97 种语言自动切换,后者增加后台推理与异步工具调用以处理多步骤任务。两款模型已接入 Gemini API 和 Google AI Studio,将语音交互从单向问答转向支持连续对话与工具执行。
谷歌DeepMind发布Gemini 3.8 Live和Gemini 3.8 Live Extended Thinking两款实时语音模型,定位为可上生产的语音Agent组件。
推荐理由:谷歌上线两款主打实时交互的语音模型,首次把复杂推理和后台工具调用融入对话流,适合研究语音Agent的工程范式。
微信员工回应“小微”隐私争议,澄清其仅按用户指令临时读取指定聊天且不留存记录。此外,黄仁勋在峰会现场接听特朗普电话并探讨 AI 末日论,Google 向全体工程师开放 Claude 但维持 Gemini 为默认模型。
 Google DeepMind精选AI 评分8888
Google DeepMind 发布 Gemini 3.8 Live 和 3.8 Live Extended Thinking,定位面向语音智能体与复杂多步任务的实时推理模型。


推荐理由:官方给出两款实时语音模型的能力定位、评测排名与分渠道开放节奏,可直接用于判断语音智能体部署方案。
 Google AI BlogAI 评分4242
Google 推出 Gemini 3.5 Live Translate,支持 70 种语言及 2,000 以上语言对的实时语音翻译。基于 1,200 万小时音频训练的 Universal Speech Model 利用跨语言迁移学习,支持“1,000 种语言计划”。TranslateGemma 家族提供 55 种语言的轻量级开源模型,实现无网络环境下的端侧高效翻译。
Google Gemini API Release NotesAI 评分5656Google 发布两款实时语音应用的新音频模型:Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking,均已在 Live API 上正式可用。
DeepSeek 发布 V4.1 Flash 模型,将快速、专家、识图三模式合并,空闲时段缓存命中价格降至 0.02 元/百万 token,降幅达 60%。谷歌推出 Gemini Windows 原生桌面应用,支持 Alt+空格全局唤起,全球可用。25 位菲尔兹奖得主联名声明,警告 AI 公司追求解题速度而忽视概念理解,正在侵蚀数学共同体根基。
马德里公司 HeyDiga 完成 550 万欧元种子轮融资,资金将用于在西班牙、法国和意大利市场进行商业扩张。该公司拥有超过 200 家客户,通过集成 28 个行业软件实现端到端电话处理,自动化率达 78%,解决率为 85.3%。
网易有道于 9 月 8 日上线首款 AI 原生语音 Agent 叭哥说,完全免费且不限额度,无需自行配置模型。实测中,叭哥说在口语整理时保留了更多原话风格,而在办公室极小声场景下识别准确率优于 12 美元/月的 Typeless。该工具将语音识别、跨语言翻译和文本输入串联,支持中译英直接写入当前输入框,并承诺语音加密传输且不留存数据。
TLDR AIAI 评分4545OpenAI 发布 Agents API 公测版,提供托管式智能体基础设施并推出全双工语音模型 GPT-Live-1,价格为 0.05 美元/分钟;因 Astra 需求暂停 200 美元/月的 Pro 订阅。
苹果发布 Apple Watch Series 12 与 Ultra 4,两款设备均搭载 S11 芯片,支持“准备指数”健康评估及“音频智能”功能。后者包含 Live Rewind 语音回溯和 Siri Recap 对话摘要,旨在构建个人智能中枢。Series 12 售价 2999 元起,Ultra 4 售价 6499 元起,均将于 9 月 18 日正式发售。
GPT‑Live‑1 正式进入 API,支持全双工语音交互。该模型提供更强的指令遵循、自定义音色以及电信支持,用于构建自然的语音应用。
国内AI音乐生成公司ACE完成4000万美金PreB轮融资,创世伙伴创投CCV、顺为资本及Alphaist等机构参投,CCV连续大额加注。ACE旗下专业工具ACE Studio已有近10万名付费创作者,月收入超200万美元,九成来自海外,积累超300万条专业音乐创作轨迹用于模型训练。
Google Gemini API Release Notes精选AI 评分6666Google 正式发布下一代音乐生成模型 Lyria 3.5 正式版。该模型支持全曲生成,提升音乐连贯性与自然人声表现,提供细粒度时长与结构控制,接受文本与图像输入,并生成 44.1 kHz 立体声高保真音频。
推荐理由:Lyria 3.5 正式 GA,用户可直接调用其全曲生成、44.1 kHz 立体声音频与更细时长的官方入口。
Meta推出由超级智能实验室开发的首个实时音频感知模型Muse Voice Transcribe,提供实时流式自动语音识别(ASR),支持超过20位说话人分割及1小时长音频处理。
推荐理由:原文明确指出该模型支持超过20位说话人和1小时长音频,并展示了在流式基准测试中的排名。
Google AI BlogAI 评分2626Google 发布了 Gemini 3.7 Flash 和 Pixel 11 系列设备。Gemini 3.7 Flash 每百万 token 定价为 Gemini 3.6 Flash 的一半,适用于编程和智能体开发。Pixel 11 系列搭载 Google Tensor G6 芯片,内置最新 Gemini Nano 模型,并支持 Gemini Intelligence 功能。


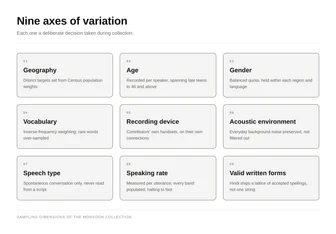
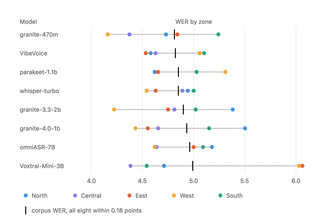
Hugging Face 与 Voice Arena 合作在 Open ASR Leaderboard 引入印地语和印度英语评测集 Monsoon en-IN 与 Monsoon hi-IN。这是该榜单首个非欧洲语言,包含 4,888 名说话人,分为公开和私有分割以限制基准优化。评测集覆盖了 9 个变化维度,并记录 12 项说话人属性,旨在解决 ASR 误差率分布不均的问题。


Google 发布 Gemini 3.5 Transcribe 语音转写模型,支持 85 种以上语言,实时版延迟低于 1 秒,非实时版词错误率 2.6%。该模型通过 Gemini API 开放,具备智能转写功能可自动清理口误,一小时录音处理成本最低约 0.30 美元。
推荐理由:原文提供了 Gemini 3.5 Transcribe 在延迟、准确率及实时与录音模式下的功能差异,有助于评估其在不同场景的可用性。
Google DeepMind精选AI 评分7676Google DeepMind 发布 Gemini 3.5 Transcribe,将其定位为面向智能语音交互的语音转写模型,并已在 Gemini 应用、Android、Gboard、Chrome 等场景提供入口。


推荐理由:模型给出明确的 WER 数据、双 API 入口和多产品集成范围,方便开发者对比 Chirp 3 判断接入与落地成本。
Google Gemini API Release Notes精选AI 评分6565Gemini 3.5 Transcribe 正式推出,包含两款专用语音转写模型。Gemini 3.5 Transcribe 支持 85 种以上语言的无流式高精度低延迟转写,提供说话人分离、词级时间戳及最多 1000 条自定义词汇偏置。
推荐理由:官方提供了两款专用模型的能力差异与技术参数,便于开发者按非流式与流式场景选型。
前MiniMax技术合伙人杨斌创立音频模型公司BreezeBlue,已获600万美元种子轮融资。其自研模型Breeze TTS 2在Artificial Analysis Text-to-Speech榜单中全球并列第四,模型侧生成延迟低至40ms,支持50多种语言。
Mistral 与 HUMAIN 宣布建立覆盖 AI 基础设施、先进模型开发和部署的战略合作,以支持沙特及中东北地区的主权 AI。双方将专注于网络安全和语音等初级领域,并开发在阿拉伯语方面表现优异的前沿模型。

Wispr Flow 完成由 Menlo Ventures 领投的 2.8 亿美元 B 轮融资,估值达 20 亿美元,并同步发布自研语音模型 Canto。文章分析了 Wispr 从单纯的语音听写工具向 AI 意图入口转型的战略,通过高频输入建立个性化数据飞轮和上下文记忆,试图在输入框层构建拦截和调度各类 AI 模型的能力。
音潮于 8 月 14 日发布 V4.0,围绕指令理解、情绪落地、曲风细分三个维度重构底层架构,解锁 10 语种全覆盖和纯音乐生成,音潮 APP、音潮 Studio、Hitto 及 API 平台同步更新。
Hugging Face 发布最新研究,引入三项测试量化语音识别模型中的“基准优化”现象。评估 11 个开源 ASR 模型发现,高分模型常在音频内容与基准转录不符时仍复现错误参考文本,甚至依赖声学线索识别基准来源。这表明现有分数可能高估了模型对通用语音的实际转录能力。


默造 MuteVox S1 完成 Pre-Seed 及 Seed 两轮百万元级融资,这款定价 799 元的设备通过物理隔音阻断声音扩散,并精准捕捉语音传输给 AI,解决公共场合语音交互难题。京东众筹已获 1243 份订单,产品正筹备进入 Kickstarter 等海外平台。
国产AI音乐团队音潮于8月14日全平台上线音潮音乐大模型V4.0,基于V3.5底层全方位重构,主打指令理解与人性化语义解读升级,正面挑战SUNO。V4.0新增俄、德、葡、意、法五大语种,实现全球十大主流语种全覆盖,并将原本仅面向B端的纯音乐生成能力开放给普通会员。同时推出音潮API Platform一站式开放平台,提供歌词生成、歌曲生成、歌曲仿写、歌曲扩写四大能力,目前处于限时免费试用阶段。
VUI Labs 发布 Luna-TTS 模型,在 Hugging Face TTS Arena 排名全球第一,并在 Artificial Analysis Speech Arena 超越 Google 位列第三。
推荐理由:Luna-TTS 登顶 Hugging Face TTS Arena 并公布扩散架构与实时延迟数据,展示了非自回归语音生成在质量与效率上的新上限。
音潮大模型 V4.0 于 8 月 14 日全平台上线,从底层重新训练而非在旧版上打补丁,核心变化集中在指令理解、情绪落地、曲风细分三个维度。V4.0 新增俄、德、葡、意、法五大语种,实现全球十大主流语种全覆盖,并将此前仅面向 B 端的纯音乐生成向普通用户开放。
NVIDIA 发布 Magpie TTS 多语言版本,作为 364M 参数开放权重模型支持 12 种语言,新增阿拉伯语、韩语和巴西葡萄牙语。模型通过帧堆叠和局部 Transformer 架构改进降低推理延迟,在 B200 GPU 单流场景下 Time to First Audio 仅为 32ms,开发者可利用开放权重在自管基础设施中定制并部署低延迟多语言语音 Agent。

推荐理由:文章解析了 Magpie TTS 在降低延迟方面的架构改进与多语言支持现状,为构建可控的语音 Agent 提供了技术选型依据。
昨日 · 电商全景
AI DAILY BRIEF
AI 经营日报 · 加载中…
AI 分析未通过内容质量检查,系统将在下一轮重新生成。当前不会展示占位内容或未经验证的经营判断。
AI 经营舱加载中…
DAILY BRIEF · 加载中...
CREATOR TUTORIALS
OPERATION WORKBENCH
把规则行动、经营日历和促销风险集中到一个工作区处理。
AIHOT NATIVE OPERATIONS
SOURCE STATUS DASHBOARD
SOURCE READING PANEL
SOURCE SUBMIT
全网精选信号实时汇聚,AI 深度解读,帮助快速决策、抢占先机
保留近 30 天高价值精选信号,按日期折叠
AI VISUAL INTELLIGENCE
把成片拆成可复用的镜头、风格与提示词
— 条真实素材 — 张真实附件封面 — 条可预览 0 条已收藏
数据真相源:飞书「AI爆款视频灵感库」。不公开附件 token、临时下载链接与推送状态。
灵感素材库 / 电商爆款拆解
从真实案例里拆出可复用句式、词根、高光点和画面元素,再进入逐秒拉片。
数据来自已授权素材台账的只读公开投影。收藏与对比只保存在当前浏览器;不公开附件凭据和账号标识。
AGENT 接入
无需登录。安装公开薄 Skill 后,Agent 通过正式域名的匿名只读接口查询电商日报、今日必看和候选信号;核心采集与评分系统仍保留在服务端。
管理员确认后会提供适合当前 Agent 的接入和验证说明。
在 Agent 对话中发送安装口令,Agent 自动读取 Skill 文档
Agent 只通过正式域名查询经过裁剪的日报、热点和来源健康数据
先完成真实问答验证;需要每日推送时再使用 Agent 平台自己的自动化
每日经营日报按主题整理的正式日报今日重点信号24 小时经营情报信号流来源健康状态信源可用性与异常提示COMPLIANCE CHECK
先用本地审核词库做初筛,不调用模型接口。命中结果仅供排查风险表达,最终以平台最新规则为准。
仅供初筛,最终以平台规则为准
ROI CALCULATOR
用期望利润模型计算退款率影响下的真实投流保本 ROI,避免只看毛利导致误判。
PROMO RISK
叠加满减、优惠券、退款率、投流成本后,评估促销活动的真实盈亏风险,避免有销量没利润。
💡 利润测算 → 判断平时单品是否值得投流;促销亏损预警 → 叠加活动优惠后,这次促销会不会亏。
这是经营测算,不代表平台或财务最终结果。
ABOUT / 电商经营情报系统
不是更多热点,是更少的误判
面向内容电商经营者的热点发现、判断与执行系统。
把全网变化,压缩成今天该做的事。
SYSTEM OUTPUT系统最终回答
持续捕捉平台、品牌、品类、AI 与内容信号
识别博主与平台热度,回看昨日完整变化
给出来源、影响、机会窗口与下一步行动
连接月度机会、教程、素材拆解与爆款案例
用行动、测算、预警和复盘协同完成落地
连接能力说明、文件与自动化执行状态

博主热点
查看抖音、小红书与 X 的博主内容、互动质量和内容机会。
博主热点
发现正在加速的创作者内容,锁定可复刻的内容机会。
平台热榜
LIVE实时更新中不以热度论英雄,用公开榜位、时效与跨平台证据推进经营决策。